音效生成自己说了算!小米开源可控视频音效生成模型 ControlFoley
2026-05-29
小米大模型应用团队发布 ControlFoley 开源模型,面向视频同步音效生成中的“可控性”难题,统一支持文本引导视频配音、文本控制视频配音和参考音频控制视频配音三类任务。ControlFoley 在多个视频音效生成任务上达到开源 SOTA 表现,在语义对齐、时间同步、声音质量以及多模态控制能力上取得全面提升。代码、模型权重、技术报告、在线 Demo 和开箱即用 Skill 均已开放。
给一段无声视频自动配上音效,已经不再是新鲜事。视频音效生成模型可以根据画面内容生成匹配的声音,让无声视频变得更完整、更有沉浸感。但进入真实创作场景后,问题很快变得更复杂:创作者往往不只希望视频“有声音”,还希望能指定声音内容和声音风格。比如,一段角色挥剑的动画,模型可以根据画面生成普通的破风声;但创作者也可能希望它听起来像清脆的金属剑鸣,或者参考某段音效素材,生成更厚重、更有打击感的武器声。
如果模型仍然只会根据画面自动猜声音,创作者就很难真正控制配音结果。视频音效生成的下一步,需要从“看画面配声音”走向“按意图配声音”。这类需求背后,指向的是视频音效生成更进一步的能力:可控生成。为此,小米大模型应用团队提出并开源了 ControlFoley,一个统一且可控的视频音效生成框架。它不只让视频“有声音”,更希望让声音真正“按你想要的来”。
01
从“看画面配声音”到“按意图配声音”
视频同步音效生成,也常被称为 Video-to-Audio(V2A)。它的目标是根据视频内容生成与画面语义一致、节奏同步、听感自然的音频。过去一年,V2A 方向已经取得了不少进展,MMAudio、HunyuanVideo-Foley、Kling-Foley、ThinkSound 等模型证明了从视觉内容生成高质量同步音效的可行性。但在更高自由度的创作场景中,仅仅“根据画面生成声音”还不够。
现有方法普遍面临三类问题:
- 文本控制弱:给了视频和文本提示后,模型往往还是更相信画面。尤其当文本和视觉内容不一致时,文本很容易被视觉信息“压过去”。创作者想要的声音没有生成出来,模型仍然生成了画面里最显眼的声音。
- 参考音频控制难:用一段参考音频控制音色或风格,本身就是一个复杂任务。参考音频里既有音色信息,也有时间节奏信息。如果处理不好,参考音频的时间结构会干扰视频本身的同步关系,导致声音风格没控准,时间也不同步。
- 多模态冲突难处理:多模态条件同时输入时,不同模态之间可能一致,也可能冲突。模型如果没有明确的控制机制,就容易在多种条件之间摇摆,生成结果不可预测。
一句话概括:视频音效生成已经能“看画面配声音”,但还很难做到“按用户意图配声音”。
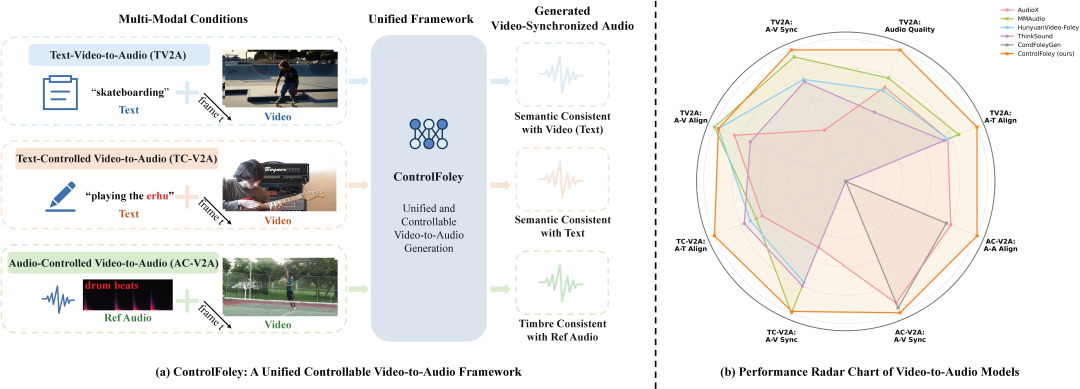
ControlFoley 的核心目标,是构建一个统一的可控视频音效生成框架,让模型同时具备三类能力:
- TV2A:文本引导视频配音。根据视频和文本提示生成同步音效,文本用于补充和细化画面中的声音语义。
- TC-V2A:文本控制视频配音。当文本和视频语义发生冲突时,模型仍能遵循文本意图生成目标声音,同时保持和视频动作的时间同步。
- AC-V2A:参考音频控制视频配音。根据视频和参考音频生成同步音效,让输出声音在音色和风格上贴近参考音频,同时不破坏视频节奏。
这意味着,ControlFoley 不只是一个“视频生音频”模型,而是一个面向创作控制的多模态音频生成模型。
创作者可以告诉它:想生成什么声音、想要什么音色风格。即使控制条件和视觉内容不一致,也可以优先表达创作意图。
这正是 ControlFoley 名字里 “Control” 的含义。
02
ControlFoley 如何实现可控?
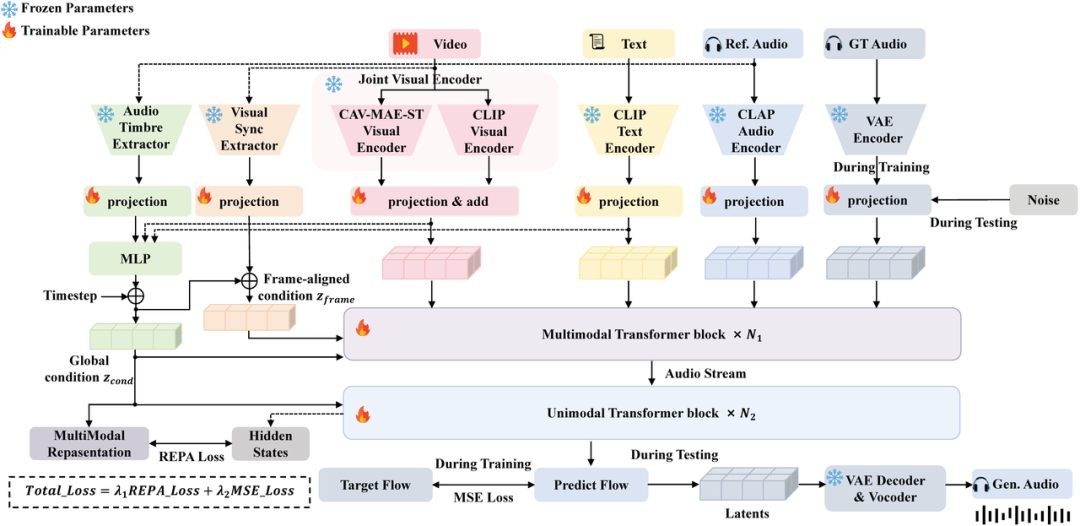 ControlFoley 模型架构:联合视觉编码、时间-音色解耦与多模态鲁棒训练共同支撑可控视频音效生成
▎联合视觉编码:既理解画面,也听懂控制意图
在视频音效生成中,视觉信息非常强势。它能告诉模型画面中发生了什么,但也容易在多模态融合时压制文本控制。为此,团队新提出并自训练了时空音视频编码器 CAV-MAE-ST,用来增强模型对音视频事件、动作节奏和时间同步关系的理解。
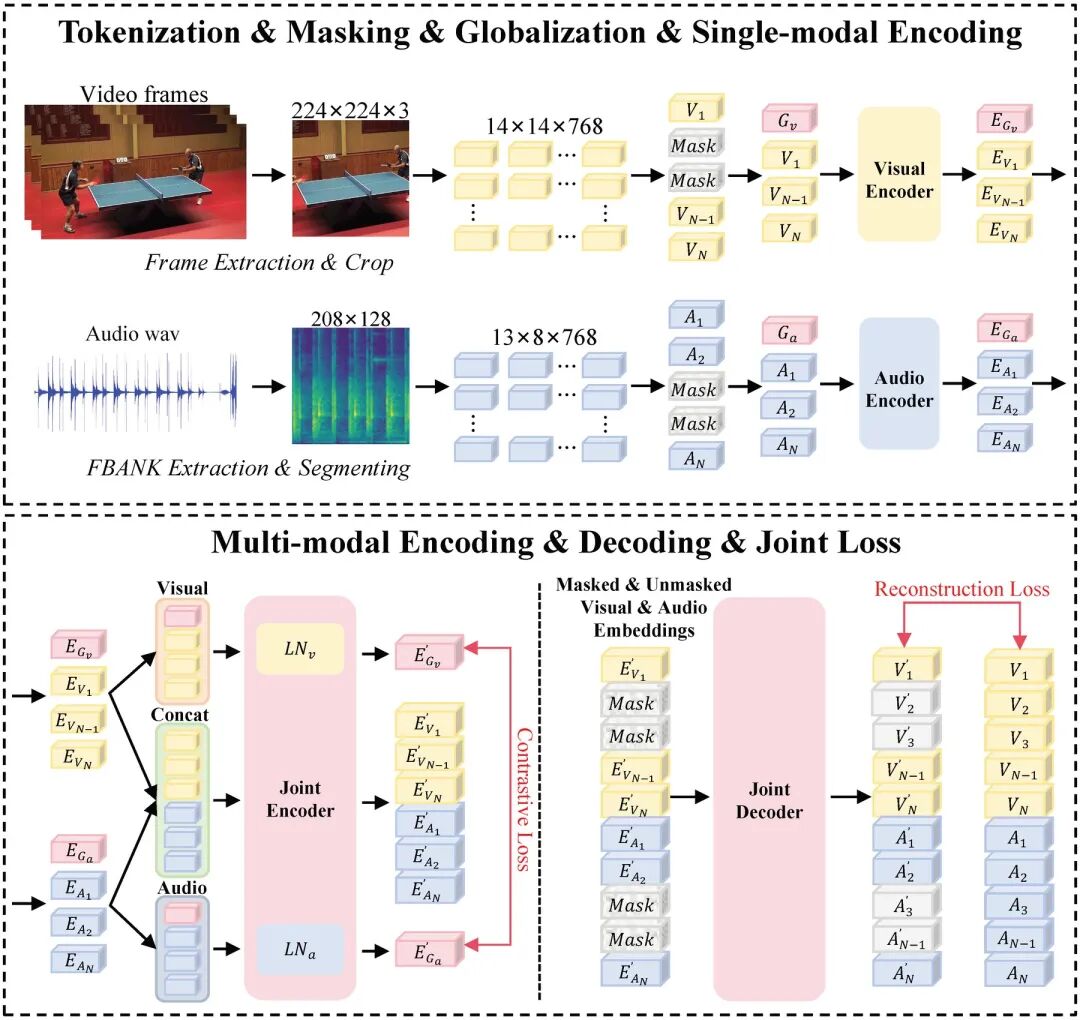 时空音视频编码器 CAV-MAE-ST
简单理解,CLIP 更擅长理解视觉与文本之间的通用语义关系;CAV-MAE-ST 则面向视频配音任务重新设计和训练,更关注“动作什么时候发生、声音应该什么时候出现”这类音视频时空对应关系。它通过视频帧与音频特征的联合建模,帮助模型捕捉动作节奏、音频事件和时间同步线索。
二者结合后,ControlFoley 既能保留强音画同步能力,又能在文本与视觉发生冲突时更好地响应文本控制。这让模型在“画面是一回事,用户想要另一种声音”的场景下,不再只是被画面牵着走。
▎时间-音色解耦:让参考音频控制风格,而不扰乱同步
参考音频控制的难点在于:一段音频里同时包含“听起来像什么”和“什么时候发生”两类信息。如果模型直接使用参考音频,参考音频里的节奏和时间结构可能会干扰视频本身的动作同步。结果就是,声音风格没控稳,音画同步也被破坏。
ControlFoley 采用时间-音色解耦策略,抑制参考音频中冗余的时间信息,保留更关键的全局音色特征。这样一来,参考音频主要负责控制“声音听起来像什么”,视频则继续负责控制“声音什么时候发生”。
▎模态鲁棒训练:一个模型,适配多种输入组合
真实使用中,用户提供的条件并不固定:有时只有视频,有时有视频和文本,有时还会额外提供参考音频。
ControlFoley 采用随机模态 dropout 和统一多模态表示对齐训练,让模型在不同条件组合下都能保持稳定。同时,模型通过统一 REPA 对齐目标,将生成音频的内部表示与聚合后的多模态条件对齐,提升语义一致性和控制鲁棒性。换句话说,ControlFoley 不是为某一个单点任务“特化”出来的模型,而是一个统一覆盖 TV2A、TC-V2A、AC-V2A 的多任务框架。
03
三类任务验证:更准、更稳、更可控
▎常规视频配音:不只是可控,基础能力也很强
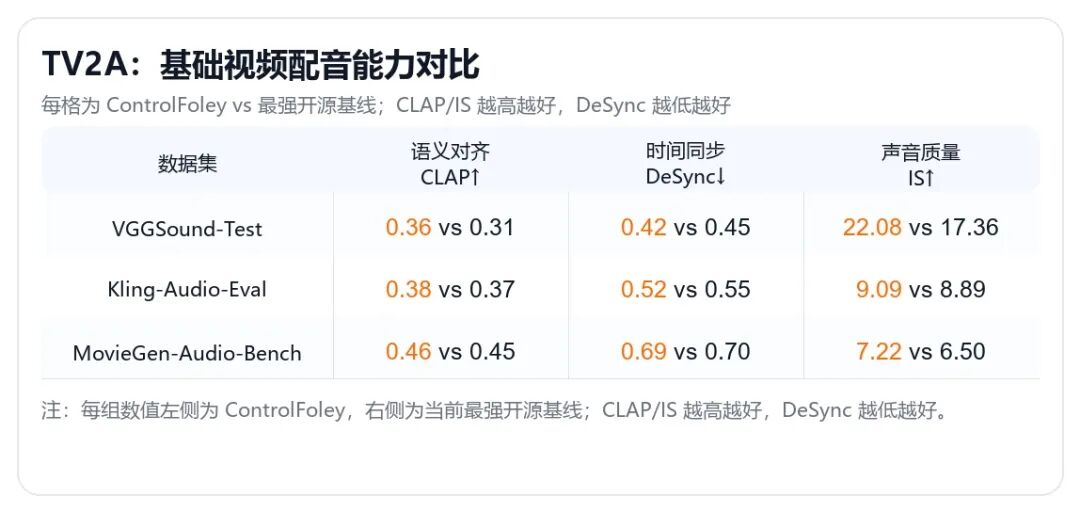
在常规视频配音任务 TV2A 上,ControlFoley 在 VGGSound-Test、Kling-Audio-Eval、MovieGen-Audio-Bench 等多个 benchmark 上取得开源 SOTA 表现。
结果对比显示,ControlFoley 在多个数据集上均取得更好的语义对齐、时间同步和声音质量表现。
下图展示了典型视频配音结果的频谱对比。以乐器演奏和体育运动两类典型场景为例,ControlFoley 生成的音频在动作发生的关键时刻能够对齐视频节奏,同时保留更完整的高频细节;相比之下,部分方法会出现声音事件错位、漏掉关键动作声音,或生成与画面不匹配的音频。直观来看,ControlFoley 不仅能“配上声音”,也更能把声音配准、配细。
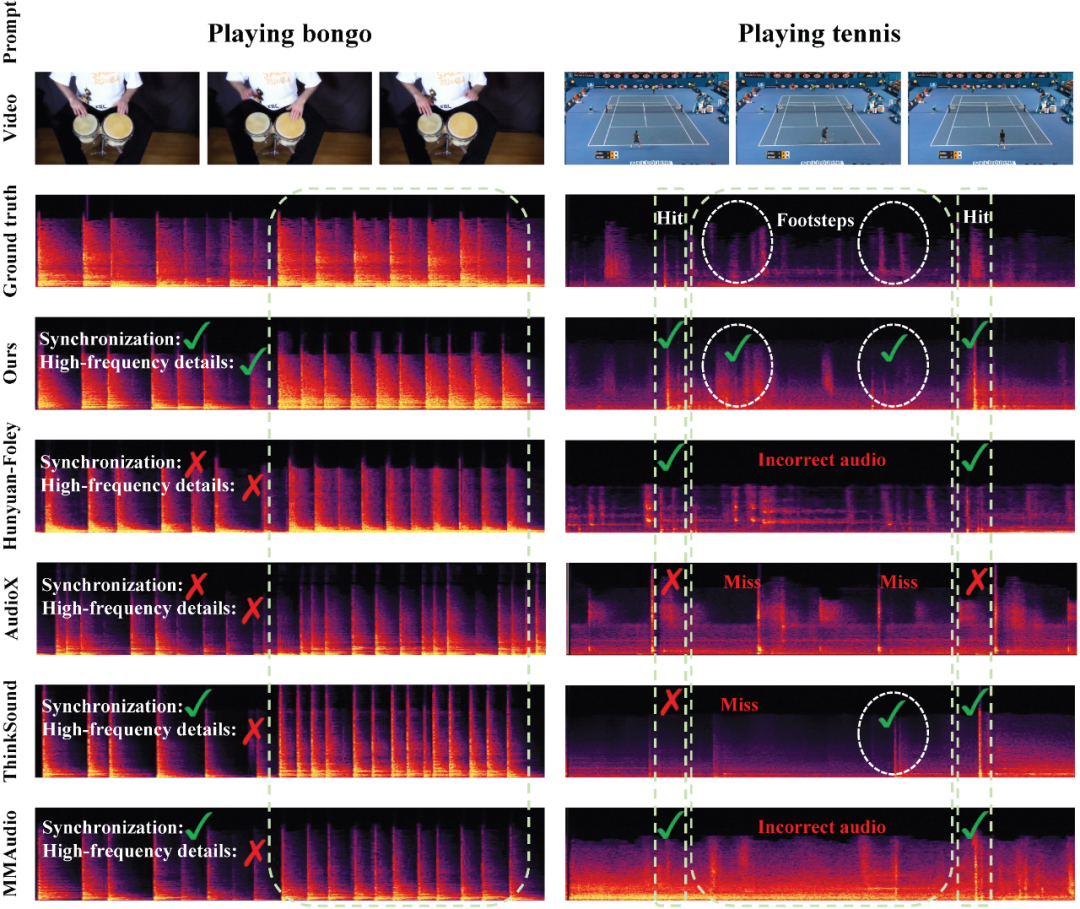
这说明 ControlFoley 不只是“更可控”,在基础视频配音能力上也具备强竞争力。
TV2A Demo:ControlFoley 根据视频内容生成同步音效,展示常规视频配音下的音画匹配能力
▎文本冲突场景:当提示词和画面不一致,听谁的?
可控生成最能体现差异的,是文本和视频发生冲突的场景。
比如一段角色敲门的画面,模型根据视觉内容可能会倾向于生成普通的敲门声;但在动画、游戏或短视频创作中,创作者可能希望这次敲击听起来像“木槌敲鼓”“金属敲击”或其他更夸张的音效,用来强化节奏或情绪。普通 V2A 模型往往更依赖画面语义,容易生成最符合画面的常规声音,而不是用户通过文本指定的目标音效。
对可控视频配音来说,理想结果不是简单“忽略画面、只听文本”,而是在遵循文本意图的同时,让声音仍然发生在视频动作对应的时间点。换句话说,模型既要听懂用户想要什么声音,也要知道这个声音应该什么时候响。
ControlFoley 针对这类场景构建了 VGGSound-TVC benchmark,用不同文本-视频语义冲突等级系统评估文本控制能力。冲突等级从 L0 到 L3,覆盖从文本与视频画面一致到强冲突的多种情况。这里主要关注两个指标:IB 衡量生成音频对视频语义的依赖程度,在文本-视觉冲突增强时,IB 越低,说明模型越不容易被画面语义“带跑”;CLAP 衡量生成音频与文本提示的语义一致性,冲突增强后仍能保持较高 CLAP,说明模型仍能听从文本控制。
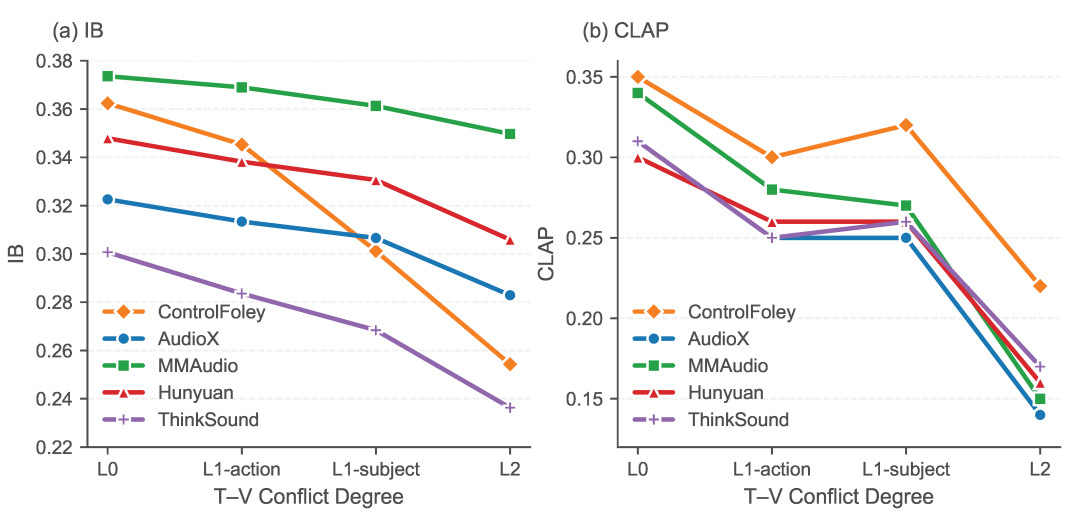 随着文本-视觉冲突增强,ControlFoley 对视频语义的依赖明显下降,同时尽量保持与文本提示的语义一致性
从实验结果可以看到,随着文本与视觉内容的冲突增强,ControlFoley 的 IB 明显下降,说明模型更能减少对视觉语义的盲目依赖;同时 CLAP 仍尽量保持在较高水平,说明生成结果仍然贴近文本提示。也就是说,ControlFoley 并不是被画面中最显眼的动作“牵着走”,而是能把用户输入的文本作为明确控制信号。
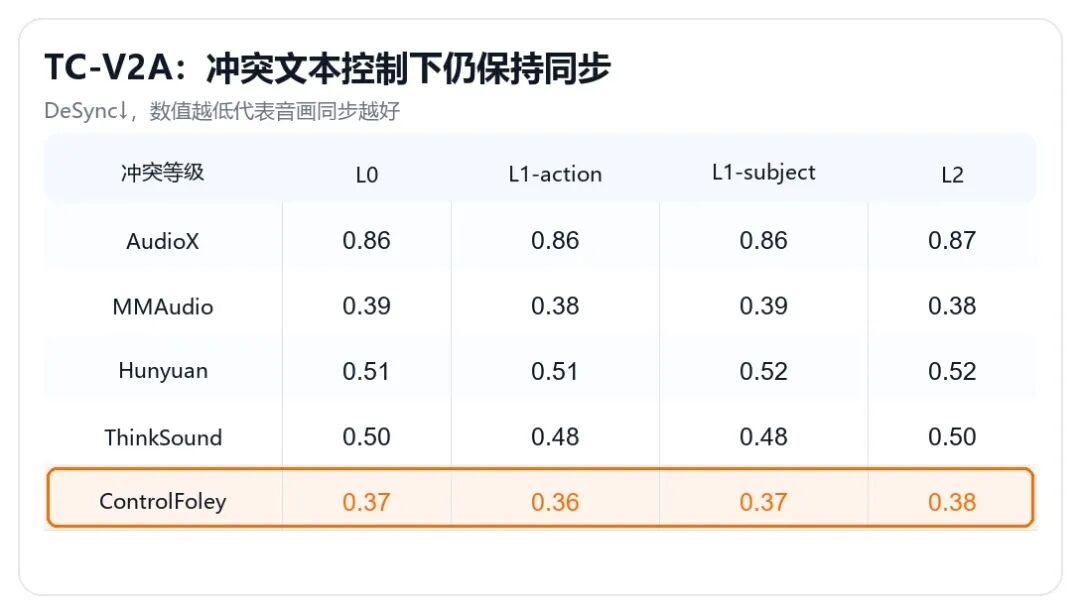
文本控制只是第一步,对于视频配音来说,声音还必须和画面动作对得上。因此,我们进一步使用 DeSync 指标评估生成音频与视频之间的时间同步性,数值越低代表同步效果越好。结果显示,随着文本-视觉冲突增强,ControlFoley 仍能保持最低的 DeSync 误差,这意味着模型在响应文本控制的同时,并没有牺牲音画同步能力。
TC-V2A Demo:即使文本指令与画面内容不一致,ControlFoley 仍能按照文本指示生成声音,并保持与视频画面的高度同步
整体来看,ControlFoley 在冲突文本控制任务 TC-V2A 上同时具备更强的文本控制能力和更稳定的音画同步能力。也就是说,当用户明确指定想要的声音时,ControlFoley 更能让文本真正“说话算数”,同时让生成音效继续贴合视频节奏。
▎参考音频控制:声音风格,也可以由你说了算
除了文本控制,ControlFoley 还支持参考音频控制。这个功能对应的是更细腻的创作需求:用户不只是想指定“是什么声音”,还希望控制“听起来是什么风格”。例如同样是敲击声,可以更清脆、更低沉,也可以参考某段音效素材,生成更接近目标音色和质感的声音。
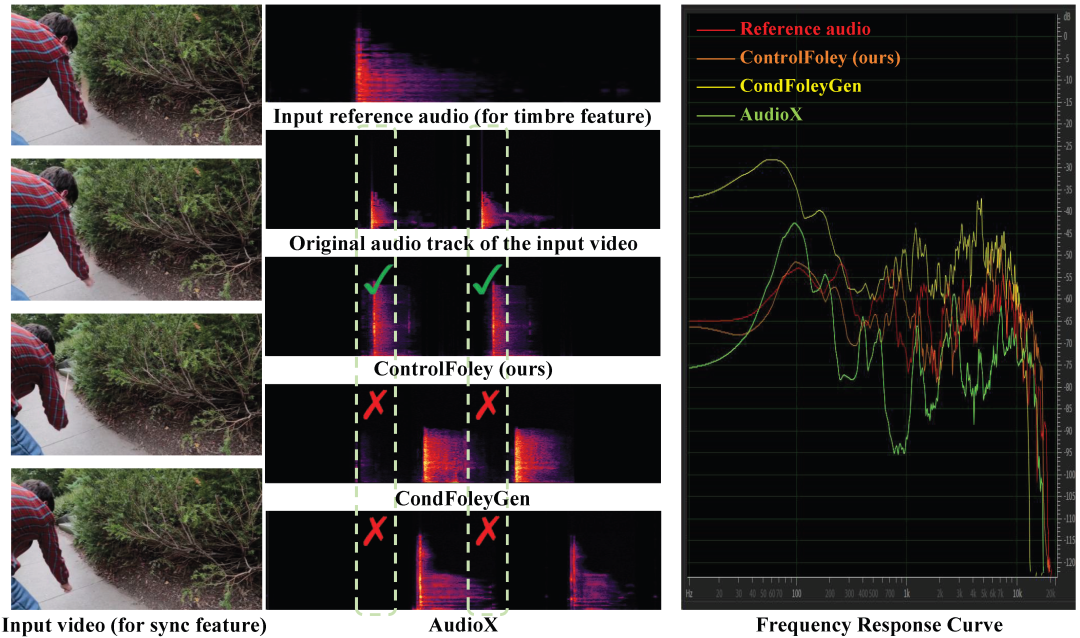
在 AC-V2A 任务中,视频负责提供动作发生的时间,参考音频负责提供音色和风格。上图的频谱对比展示了这一点:ControlFoley 生成的声音在关键动作时刻与视频保持同步,同时在频率响应上更接近参考音频。相比之下,其他方法可能出现时间错位、漏掉动作声音,或音色风格偏离参考音频的问题。
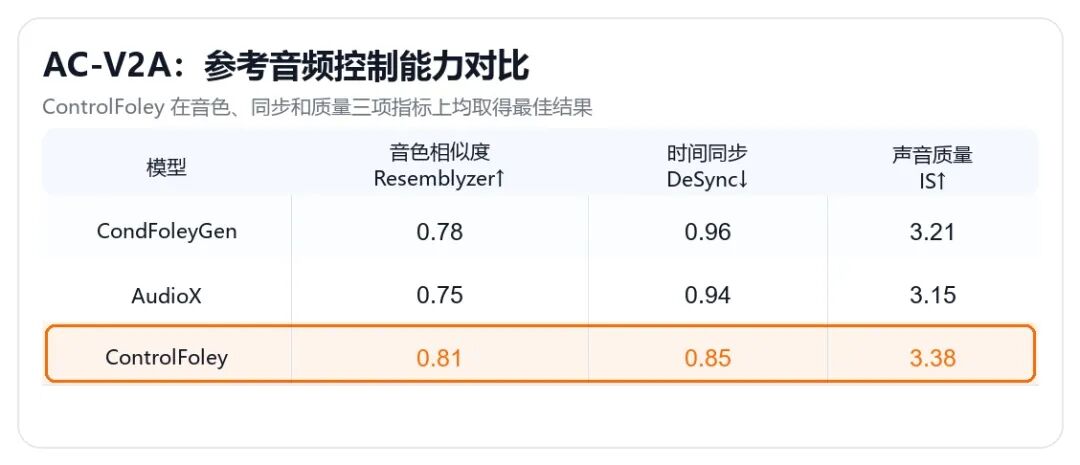
量化实验结果也验证了这一点。ControlFoley 在音色相似度、时间同步和声音质量等指标上均取得最佳表现,并超过了专门针对 AC-V2A 任务设计、在同域数据上训练的 CondFoleyGen,说明它不仅能利用参考音频控制声音风格,也能保持较好的音画同步和泛化能力。
下面的 Demo 展示了这一能力:输入视频是一段打网球画面,参考音频是一段战鼓击打声。ControlFoley 会根据网球击打动作生成同步音效,同时让声音听起来接近战鼓的音色和质感。也就是说,模型既保留了视频中的动作节奏,又把参考音频的声音风格迁移到了生成结果中。
AC-V2A Demo:给打网球的视频配上“战鼓质感”的击打声。ControlFoley 根据视频动作决定声音出现的时刻,并参考战鼓音频控制生成结果的音色和风格
对标商业闭源系统,ControlFoley 同样具备竞争力。
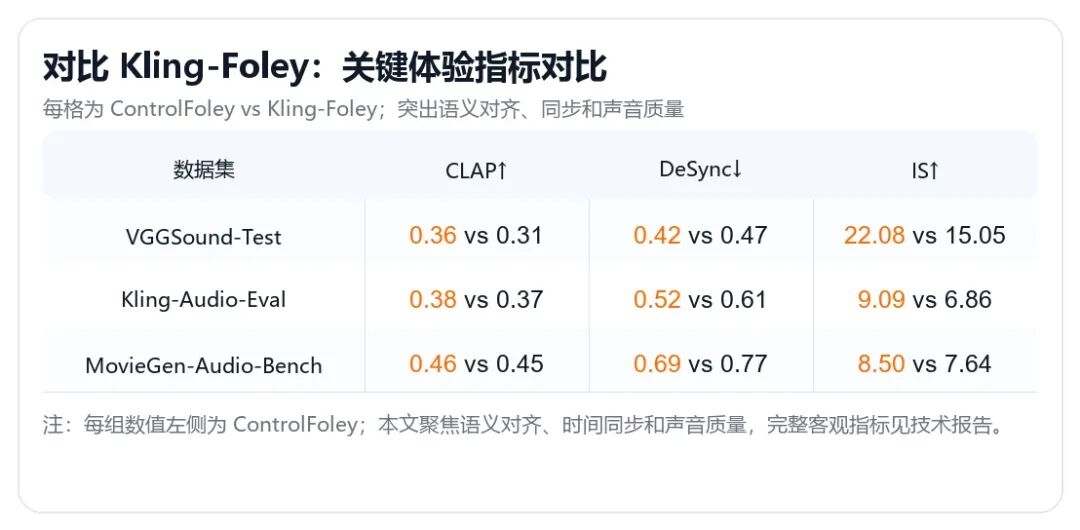
进一步对标商业闭源系统 Kling-Foley,ControlFoley 在关键体验指标上同样展现出竞争力。在语义对齐、时间同步和声音质量等关键体验指标上,ControlFoley 相比 Kling-Foley 展现出稳定优势;完整客观指标可见技术报告。
更重要的是,ControlFoley 的性能优势并非来自更大的训练规模,而来自更有针对性的模型设计:联合视觉编码、时间-音色解耦、多模态鲁棒训练共同提升了模型在多任务、多条件、多冲突场景下的稳定性。这对于开源社区尤其重要。它说明,在视频音效生成这个方向上,通过更合理的可控生成机制,开源模型同样可以在核心体验上达到领先水平。
ControlFoley 的核心价值,是让创作者真正控制声音。
上述所有结果说明,ControlFoley 的价值不只是生成质量更高的视频音效,而是把视频配音从“模型被动匹配”推进到“创作者主动控制”。
对于视频创作者,这意味着短视频、影视片段、游戏动画、广告素材中的音效生成可以拥有更高自由度:既能让声音贴合画面,也能通过文本和参考音频指定更具体的声音内容与风格。对于研究开发者,ControlFoley 也开放了代码、模型权重、在线推理和 Skill,方便快速体验、复现和二次开发。
更进一步看,ControlFoley 回答了多模态生成中的一个关键问题:当视觉、文本、音频条件同时存在,甚至互相冲突时,模型应该如何理解并执行用户真正的控制意图?
ControlFoley 给出的答案是:让不同模态各司其职,让用户意图成为生成过程中的明确控制信号。
04
开源已上线,欢迎体验
目前,ControlFoley 的相关资源已经开放,欢迎点击相关链接了解体验:
- 技术报告:https://arxiv.org/abs/2604.15086
- GitHub:https://github.com/xiaomi-research/controlfoley
- 模型权重:https://huggingface.co/YJX-Xiaomi/ControlFoley
- 项目主页 / 在线体验:https://yjx-research.github.io/ControlFoley_web_page/
- 一键调用Skill:https://clawhub.ai/yjx-research/controlfoley-audio-generator
- 完整结果对比:https://yjx-research.github.io/ControlFoley/
视频音效生成的下一步,不只是让无声视频变得有声,而是让创作者真正参与声音的创作。ControlFoley 希望推动的,正是这样一种更可控、更贴近创作意图的视频音效生成方式。声音如何呈现,由你决定。