声音基座模型怎么做?Xiaomi Dasheng:8卡起步的 AI 工程实践
2026-06-12
所谓“通用声音表征”,是指让一个模型同时听懂语音、环境声和音乐。而三年前,音频领域鲜有通用预训练的尝试。非语音的音频事件分类各走各路,语音、声音、音乐之间的空地几乎没人涉足。我们从一台8卡机器开始,用掩码自编码学声音表征,用千小时数据验证规模效应,用六维度标注打通声音到语言,最后让理解和生成共用一个模型。Xiaomi Dasheng 系列每一步都踩在没有现成答案的地方,本文分享的就是技术路径上几个关键判断,以及在无人区做选择时,那些事后被验证的直觉。
01
技术选型:基于 MAE 构建音频预训练框架
手机、音箱、电视、摄像头...... 设备上都搭载了麦克风,但它们对于声音是“盲”的,只能识别语音,对其他声音一概不知。雨声、风声、婴儿哭声、厨房的异常响动,在设备眼里都只是“非语音信号”。
让设备“听懂”声音,是从产品需求里长出的洞察,也是 Xiaomi Dasheng 诞生的初衷。
但真正动手才发现,音频领域长期以语音识别(ASR)为主流方向,“理解声音本身”这个方向缺乏算法基础、缺乏数据积累、缺乏工程路径。我们面对的是三个层面的空白,每一个都需要从头解决。
音频领域当时的一个困境在于:没有一个高效且可 Scale 的预训练方法。文本领域2017年就找到了 Transformer,2020年算法已经成熟,输入文本和输出文本的训练范式是确定的。音频领域则有所不同,语音识别模型做不了声音分类,声音分类模型做不了语音识别,两者在技术路径上存在本质差异。要做通用声音理解,需要从底层重新构建。
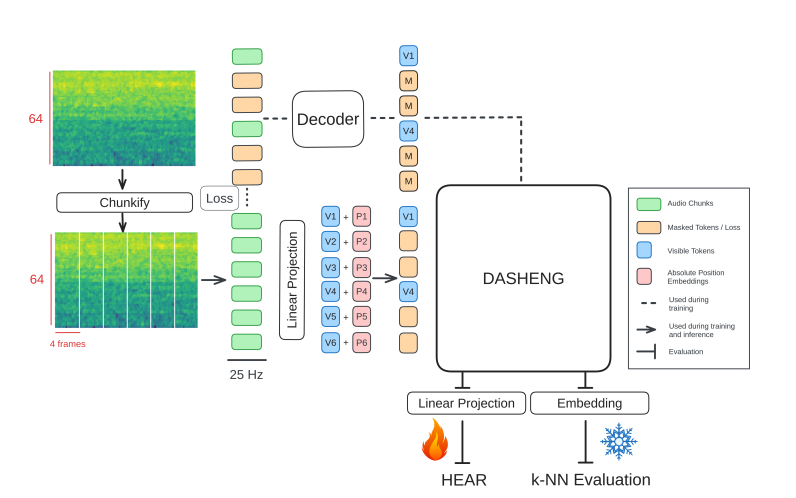
我们最终选择了 Meta 在视觉领域提出的 Masked Autoencoder(MAE)框架。原理是将音频频谱的部分遮掉,让模型学会补全被遮挡的区域。通过这个过程,模型被迫学习声音的本质结构,而非针对特定任务的表面特征。
选择 MAE 而非在已知的语音识别路径上做增量改进,这个判断来自当下的认知:我们需要的是一个通用的声音表征,不是某个任务上的极致性能。已有的路径可以在特定任务上做增量优化,但当优化走到极致了,就不应该继续加码,而是得换一条路重新出发。所以,我们面临的不只是一个技术选型问题,更是一个路线选择。
增量优化和底层重建不是程度的差异,是方向的差异。预研的价值之一,是帮团队识别什么时候该换方向。
02
数据工程:海量音频的筛选与扩量实践
算法确定之后,下一个问题是数据。人说话的音频随处可得,但风声、水声、猫叫、音乐等非语音类声音几乎没有人系统性地收集过。
从公开来源获取的视频,80%-90%都包含人声,纯粹的环境声和音乐极为稀缺。最终使用了当时最大的公开音频数据集,它涵盖约1000年的开源数据。这是团队第一次大规模使用该数据集进行声音预训练的尝试,原始数据是无监督的,没有标注。通过视频-音频同步信号可以筛选出有意义的数据,如画面中出现狗的同时也有狗叫声,就认为这段数据在语义上是有效的。
数据工程的挑战不止于此。原始数据量巨大(~300T,相当于连续播放几百万小时的声音),存储空间不足。数据集分成146个包,覆盖了语音、音乐、环境声、机械噪声等声音类型,通过多台机器、错峰下载上传的方式完成搬运,整个过程持续约一年。最终,仅用1台机器8张卡,完成了从 Base 到1.2B 参数的全部训练。
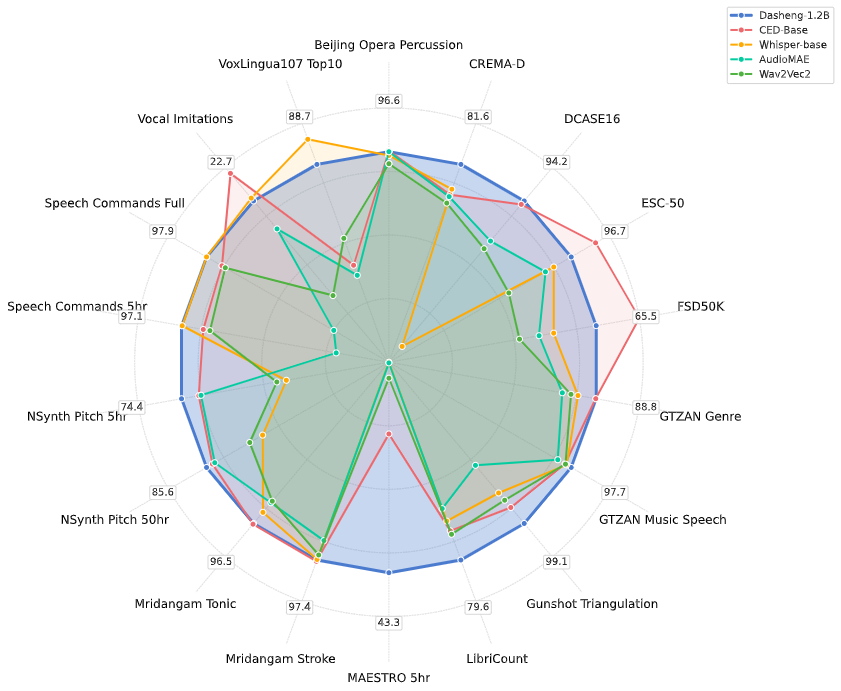
规模扩展的收益是实证性的。在 HEAR 基准测试上,从 Base(86M 参数)到1.2B 参数,平均性能从78.88提升到81.25;而将训练数据从 AudioSet 的5000小时扩展到27万小时后,三个规模的模型分别额外提升了6.37、8.69和8.45个百分点。这一结果让团队相信,“模型越大、数据越多”在音频领域同样是一个值得探索的方向。
但这个探索并非一帆风顺。团队曾把训练数据集扩容至原有10倍体量,本以为遵循“数据越大模型越强”的缩放规律就能解决问题,结果出乎意料扩充后的模型在 AudioSet 公开测试集指标不升反降,切回业务场景测试,实测效果同样变差。
这个卡点让我们意识到一个重要的事实:开源基准上的指标和实际业务指标高度正相关,这意味着在这个开源任务上每一点真实的提升,都可能在业务上产生实际价值。同时也认清了一个关键原则:盲目扩量是无效的,音频数据的质量优先级远大于单纯的数据体量。
模型发布后在开源平台上取得了一些进展:音频标记算法首次突破 AudioSet 50+ mAP;mini 版模型以49.0mAP 大幅超越当时同类模型,参数量仅为其约1/10。但大模型效果好,终端设备跑不起。基于 CED(Consistent Ensemble Distillation)知识蒸馏技术,从大型教师模型集成中蒸馏出小模型,使 Xiaomi Dasheng 能真正部署到小米的终端设备上。小米内有不少项目使用 Xiaomi Dasheng 技术落地。
GLAP 的实验验证了 Xiaomi Dasheng 在通用性上的优势:在五个编码器的对比中,只有它在语音、声音、音乐三个检索任务上同时表现良好。
这一结果可以从训练范式上找到解释:判别式编码器(如 CED、Beats)针对特定任务优化,在声音和音乐上表现好,但遇到语音就“偏科”;生成式编码器(如 Xiaomi Dasheng)通过“补全被遮挡的频谱”学到更本质的音频结构,三大领域都能兼顾。
开源基准不是终点,但它是预研阶段最诚实的验证手段。在业务场景全面铺开之前,开源指标上的真实提升就是最可靠的信号。
03
语义拓展:六维标注实现音频自然描述
Xiaomi Dasheng 能理解声音了,但输出形式是分类概率值。普通人看不懂,即使是专业人士,概率值也缺乏语义丰富度,例如它告诉你“有风声”,但无法描述外面的声学场景“外面刮着大风,有人在远处说话”。声音理解需要更丰富的表达方式。
于是有了下一步:让声音模型具备文本输出能力。技术架构是 Xiaomi Dasheng 编码器 + 大模型解码器。
行业常规做法是用 ASR 转录做音频-文本对齐,只能理解“人说了什么”,会丢弃环境声、音乐、情感、空间混响等信息,但在 ACAV100M 数据集上,这种做法会损失高达90%潜在有用数据,等同于花了大量精力去“听懂”万物,最后在对齐环节又把大部分信息扔掉了。
后来,团队找到了一个关键突破:通用音频描述对齐。用多专家分析管道做细粒度标注(语音、人声、音乐、环境声学,2秒粒度),再通过大模型合成统一描述。这个范式转变为 MiDashengLM 的设计提供了直接参考。
在此基础上,进一步构建了6维度 Caption 数据集 ACAVCaps 覆盖语音内容、说话人情绪、背景声音、音乐、场景环境、音频类型配套 MECAT Benchmark,全部开源。这个数据集的诞生其实有点意外,在项目初期时,团队沿用了行业只用单句文本描述整段音频的通用方案,但效果不佳。后来有同事提出拆分6个维度做细粒度标注,一开始大家都不看好,认为多维度信息冗余、对模型理解并无增益。但后续做音频生成实验时发现,六维精细化标注恰恰是模型生成真实声场音频的关键。
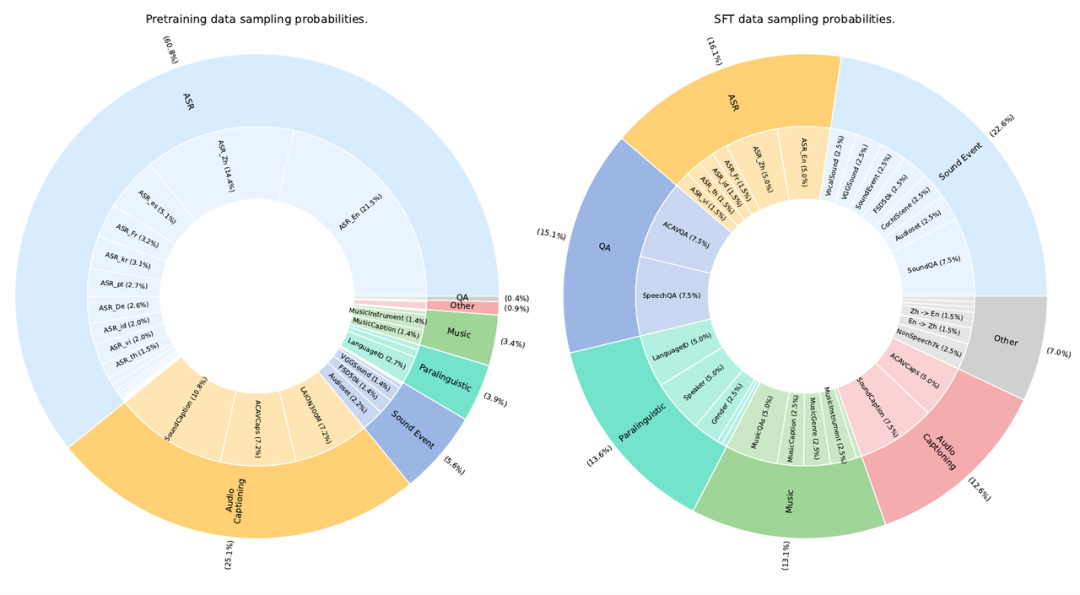
这里有一个值得注意的现象:通用音频描述的训练损失比 ASR 更高。传统观点通常认为损失越低越好。但团队在实践中发现,损失值本身不说明全部问题,损失在度量什么可能更值得关注。
ASR 的语音和文字之间是简单的“从左到右”映射,模型很快就能拟合,损失自然低,但这可能恰恰意味着它学到的东西比较有限。通用音频描述融合了语音摘要、环境声描述和音乐描述,模型需要理解更复杂的语义才能完成任务,训练损失反而更高。
基于这一观察,团队判断:在通用音频理解中,更高的训练损失可能意味着更丰富的学习信号。
MiDashengLM 在22个公开评测集上取得 SOTA。TTFT 仅为业界先进模型的1/4,同等显存下吞吐效率是其20倍以上。
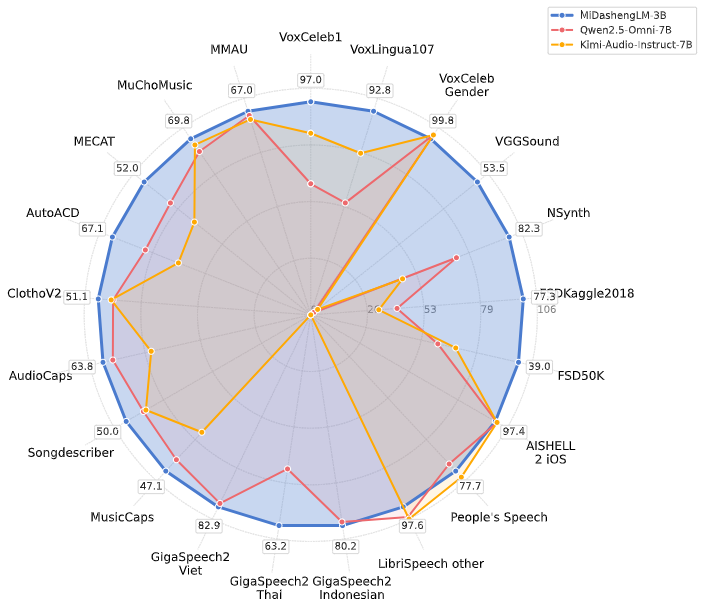
同时发布了0.6B 轻量版本,支持 CPU 部署和浏览器 WebAssembly 运行,从云端到边缘设备全覆盖。整个技术栈数据(ACAVCaps)、模型、代码全部开源。
这些观察让团队倾向于一个方向:生成式预训练 + 多维度描述数据,是通向通用音频理解的一条可行路径。但理解只是第一步 Xiaomi Dasheng 能“听”了,还不能“说”。
预研中被质疑最多的方向,有时恰恰是最有价值的。六维度标注从“没人看好”到“成为关键”,说明预研团队需要容忍一定程度的“低效探索”。
04
架构突破:打破理解与生成的模型壁垒
Xiaomi Dasheng 能听也能描述了,但理解和生成仍然是两个独立的模型编码器负责听,解码器负责说。两套模型意味着两倍的计算资源和部署成本,且两者之间缺乏协同。
行业通行做法是先训练声学编码器做理解,再训练声学解码器做生成,两者独立。两个模型意味着两倍的计算资源、两倍的部署成本,且难以在同一个模型中同时做理解和生成。
理论上也可以只对音频编码器做量化,但压缩后的特征会丢失细节,导致解码器需要更多数据和算力来补偿,训练成本可能不降反升。
为什么很少看到统一的做法?一个可能的原因是,传统生成模型理论有一个常见假设:高维度特征不太适合直接用于生成。生成通常需要压缩到低维隐空间,高维特征信息较“散”,解码器利用起来有难度。这个假设在相当长的时间里被广泛接受。
DashengTokenizer 的尝试,就是探索这个假设的边界。
我们通过冻结 Dasheng 的语义特征,仅注入声学信息,用一层结构就实现了理解和生成的统一,让同一个编码器既能“听”又能“说”。
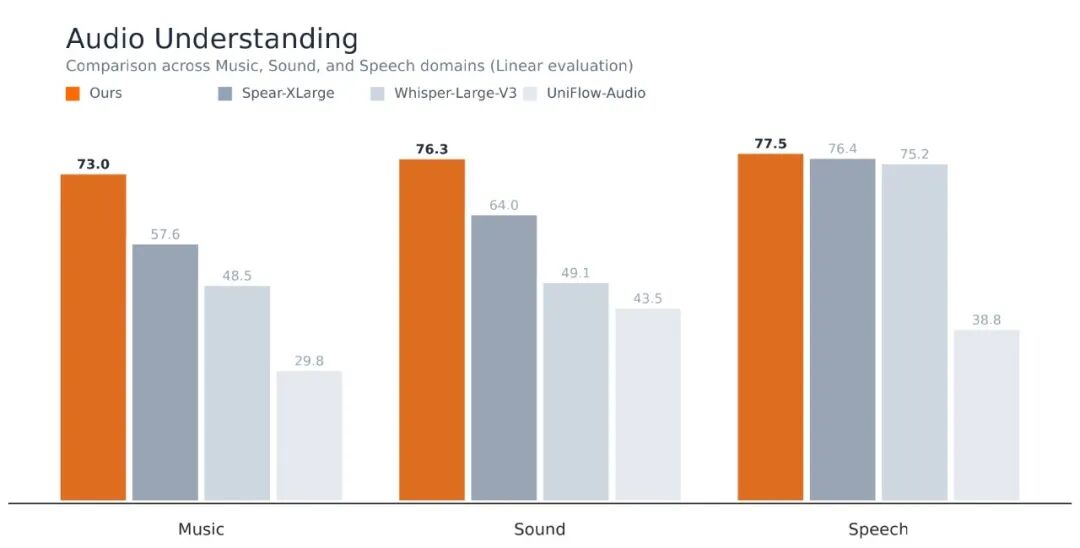
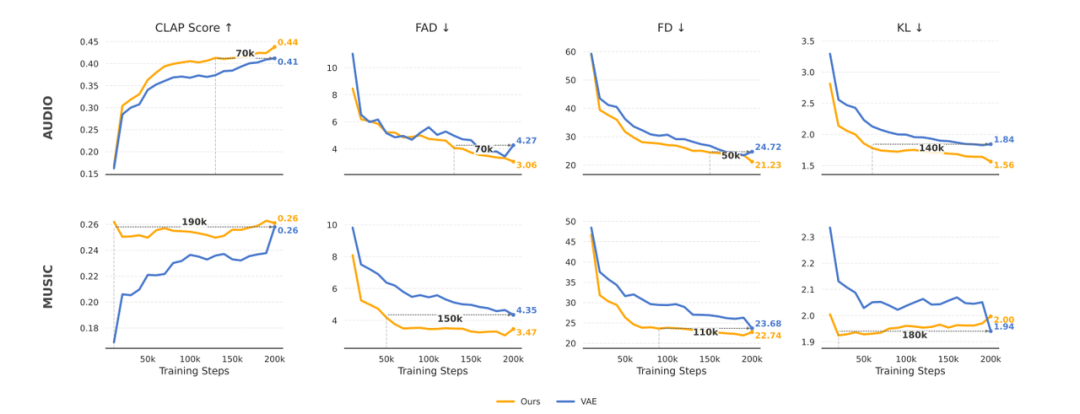
在22个任务上,DashengTokenizer 显著超越了此前使用的音频编码器和音频编解码器。在文本到音频、文本到音乐、语音增强任务上全面超越标准 VAE 方法。
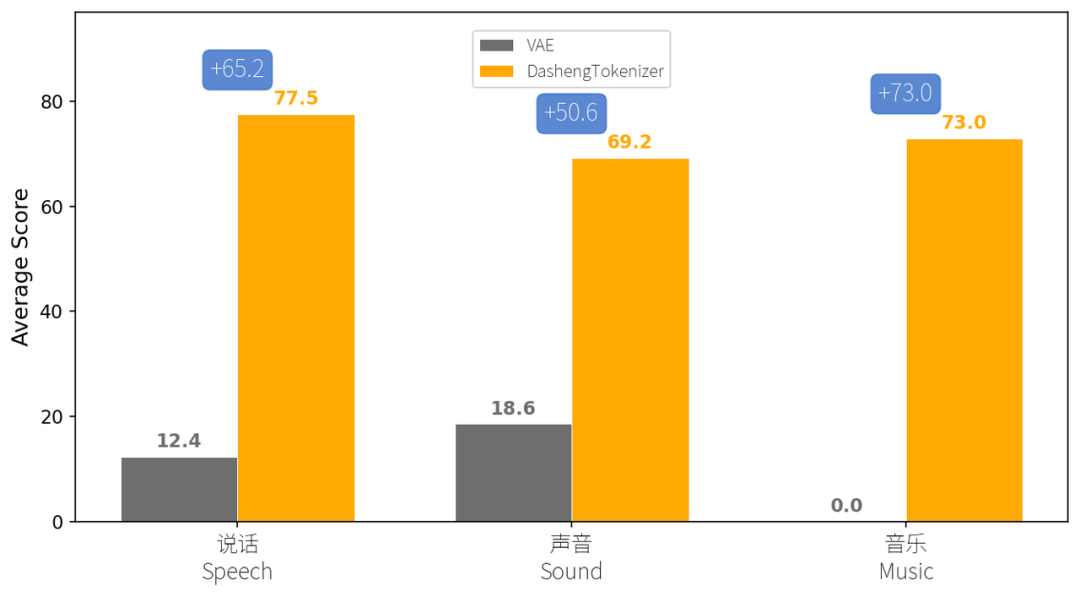
这一实验说明:VAE 架构不再是音频合成的必要条件。虽然结论不在我们的预期之内,但它可能是 DashengTokenizer 最重要的贡献,把一个没有答案的题目,解答了。
挑战行业假设不是为了推翻它,而是为了搞清楚它的边界在哪里。DashengTokenizer 的价值不是否定了 VAE,而是证明了 VAE 不是唯一解。
05
后续探索:深耕场景化音频生成能力
梳理 Xiaomi Dasheng 系列的技术路线,每个阶段之间存在着清晰的延续:MAE 预训练提供了通用表征的基础,大规模数据工程验证了 Scaling 的可行性,通用音频描述打开了语义输出的空间,DashengTokenizer 则打通了理解与生成的统一。
从“给设备装耳朵”到“给设备装嘴巴”,每一步都建立在上一步的基础之上。Xiaomi Dasheng 在解决一个又一个问题的过程中,逐步拓展了技术的边界,走入一个无人涉足的领域,是预研技术的魅力,也是创新的必经之路。这件事还在进行中。
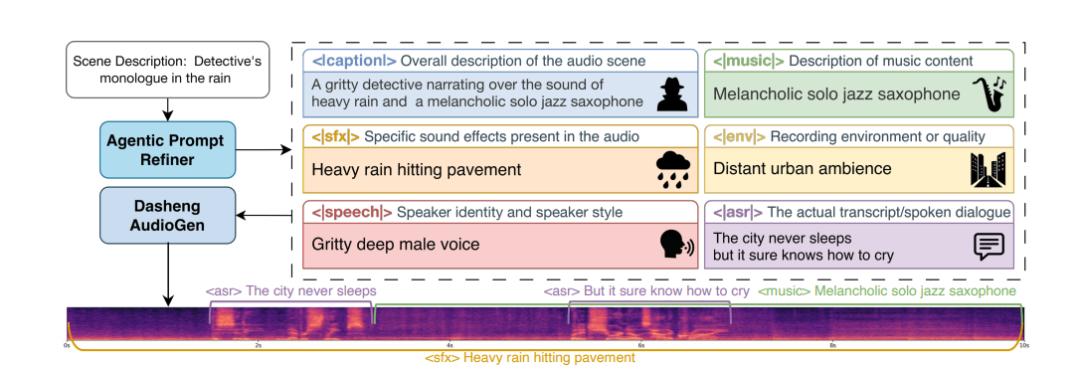
下一步,是让机器不只能听、能说,还能“造”出逼真的声学场景。团队也正在打磨新的作品“DashengAudioGen”,它将尝试让生成的声音更贴近真实场景不只是干净的语音合成,而是带环境音、背景噪声、回声和远近感的完整声学场景。