一步修复严重退化人脸视频、边看边想让视频大模型响应速度提升15.7倍——小米多篇论文入选 ECCV 2026
2026-07-02
单步推理就能修复严重退化的人脸视频,让修复结果既清晰又像本人;视频大模型不再“看完再想”,而是边看边思考,响应速度提升 15.7 倍;美学模型不再孤立打分,而是像人一样在比较中感知美的高低。这些亮眼的成果,只是小米 AI 团队与自动驾驶团队入选 ECCV 2026 的 12 篇论文中,一部分研究的缩影。
小米本次入选的论文覆盖人脸视频修复、GUI Agent、端到端图像翻译、多模态检索、流式视频推理、图像美学评估,以及自动驾驶世界模型、VLA 决策、安全规划等方向。相关研究为小米在视觉理解、多模态交互、智能体能力和自动驾驶智能等方向的基础能力建设提供了重要技术支撑与优化方向。
ECCV(European Conference on Computer Vision)是计算机视觉领域国际顶级会议之一,由欧洲计算机视觉协会(ECVA)主办,与 CVPR、ICCV 并称计算机视觉三大顶会。ECCV 每两年举办一次,ECCV 2026 是第 19 届,将于 2026 年 9 月 8 日至 12 日在瑞典马尔默举办。本届会议共收到 10473 篇有效投稿,录取 2883 篇论文,录取率约为 27.5%。
01
视觉理解与生成,让 AI 从“看清楚“到“修得好、想得快”
大模型不只需要看懂图片和视频,还要能修复视觉内容、判断视觉质量,并在实时视频流中持续推理。小米本次入选的相关论文,覆盖人脸视频修复、图像美学评估和流式视频理解三个方向,推动视觉模型从“被动感知”走向“主动理解”。
▎TIGER: Taming Identity, Geometry, and Generative Priors for High-Quality Face Video Restoration
*表示共同第一作者
合作者单位:香港科技大学(广州)
论文作者:周炀*,李文雪*,张鹏,陈一飞,王飞,周代国
项目链接: https://yzhoulv.github.io/Tiger/
论文链接: https://arxiv.org/pdf/2606.24336
人脸视频修复是视频恢复中最具挑战性的任务之一。它不仅要把模糊、噪声、压缩伪影去掉,还要保证修复后仍然像本人、表情姿态自然、视频前后帧稳定。现有方法面对强退化视频时,往往顾此失彼:修得清楚却不像本人,保住身份却牺牲表情,或者画质好但推理太慢。
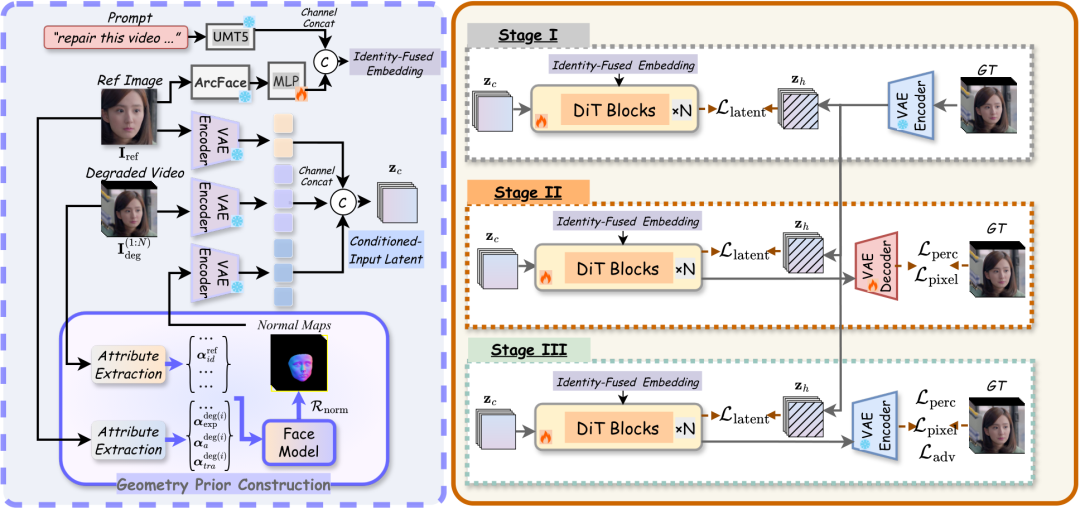
TIGER 提出结构化三先验融合框架,同时应用 Identity、Geometry 与 Generative 三类先验。模型利用参考图像提取身份嵌入,稳定目标人物身份;将参考线索提升到解耦的三维参数空间,构建时序一致的几何先验;再利用视频生成模型的生成先验,将修复过程建模为 single-step Rectified Flow,实现单次前向推理完成高保真人脸视频修复。
同时,我们构建了大规模人脸视频修复数据集,用于支持鲁棒训练与标准化评测。充分的实验结果表明,TIGER 在身份保持、时序稳定性和视觉真实感方面均取得了领先效果,能够在高效推理的同时生成身份一致、细节丰富且动态自然的人脸修复视频,并在多个基准上验证了其泛化能力。
▎Beyond Absolute Scores: Relative Edit-induced Difference for Generalizable Image Aesthetic Assessment
*表示共同第一作者
论文作者:贾麒霏*,姚昕彤*,张亚森,李明浩,柴亚捷,卢启明,申宝越,史润宇,黄英,张跃
论文链接: https://arxiv.org/pdf/2606.05778
“这张照片好看吗?”这个看似简单的问题,是图像美学评估领域的核心难题。现有方法大多只让模型学习绝对美学分数,但人类审美往往不是绝对打分,而是比较判断:这张是不是比那张更好看?绝对分数范式在跨数据集、跨场景泛化时容易失效。
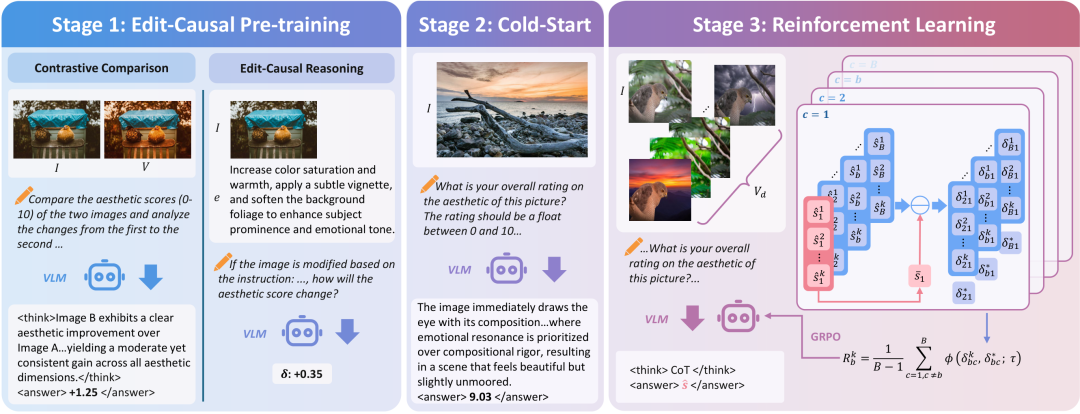
RED-Aes 从问题建模上做了转换:不再学习单张图的绝对分数,而是学习编辑前后图像的相对美学差异。研究团队构建 RED-20k 数据集,利用多个图像编辑大模型生成源图像—编辑图像对,再通过专家模型达成共识,标注相对美学差异和思维链解释。训练上,先通过对比与因果预训练注入美学知识,再用 GRPO 强化学习优化排序能力。
实验结果显示,RED-Aes 的 7B 模型在五个公开基准的零样本评估中全面超越 GPT-5 及此前专家模型,2B 轻量版也超过所有现有基线。这表明,相对差异学习能够帮助模型更有效地习得通用美学原则,为图像生成、编辑和内容质量评估提供了新的技术支撑。
▎Video Streaming Thinking: VideoLLMs Can Watch and Think Simultaneously
*表示共同第一作者
论文作者:管一然*,尹亮*,梁定康,鞠建忠,罗振波,栾剑,刘禹良,白翔
论文链接: https://arxiv.org/abs/2603.12262
代码链接: https://github.com/1ranGuan/VST
在线视频大模型要支持实时交互,难点不只是“看懂视频”,而是能不能在视频播放过程中同步思考。传统 VideoLLM 通常是“先看完整段视频,再开始推理回答”,这会带来明显响应延迟,也容易让模型遗忘早期关键线索。
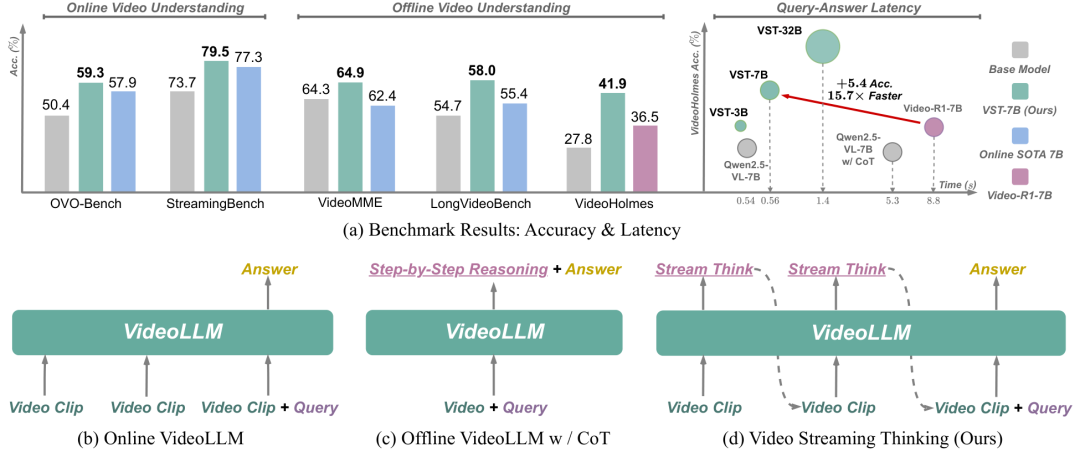
VST 提出 thinking while watching 的流式视频理解范式,让模型在视频流持续输入过程中同步激活推理能力。模型会随着新片段到来持续生成中间思考,实时整理事件、实体、因果关系和关键线索。团队进一步构建 VST-SFT 和 VST-RL 后训练流程,并设计基于视频知识图谱的自动训练数据合成管线,提升模型的流式推理能力。
实验显示,VST-7B 在 StreamingBench 上达到 79.5%,在 OVO-Bench 上达到 59.3%;相比 Video-R1,VST 在 VideoHolmes 上响应速度提升 15.7 倍,并获得 +5.4% 性能增益。这意味着 VideoLLM 正在从“看完再想”的被动模式,走向“边看边想”的实时推理模式,为流式视频理解和实时多模态交互提供了新的优化方向。
02
大模型应用,从“能演示”到“真能用”
从 GUI Agent 到图像内翻译,再到多模态检索,大模型真正走向真实任务,需要解决的不只是模型能力问题,更是任务可靠性、视觉一致性和复杂意图理解问题。以下三篇论文,分别从动作判断、图像翻译和多模态检索三个方向,推动大模型应用从 demo 走向真实场景。
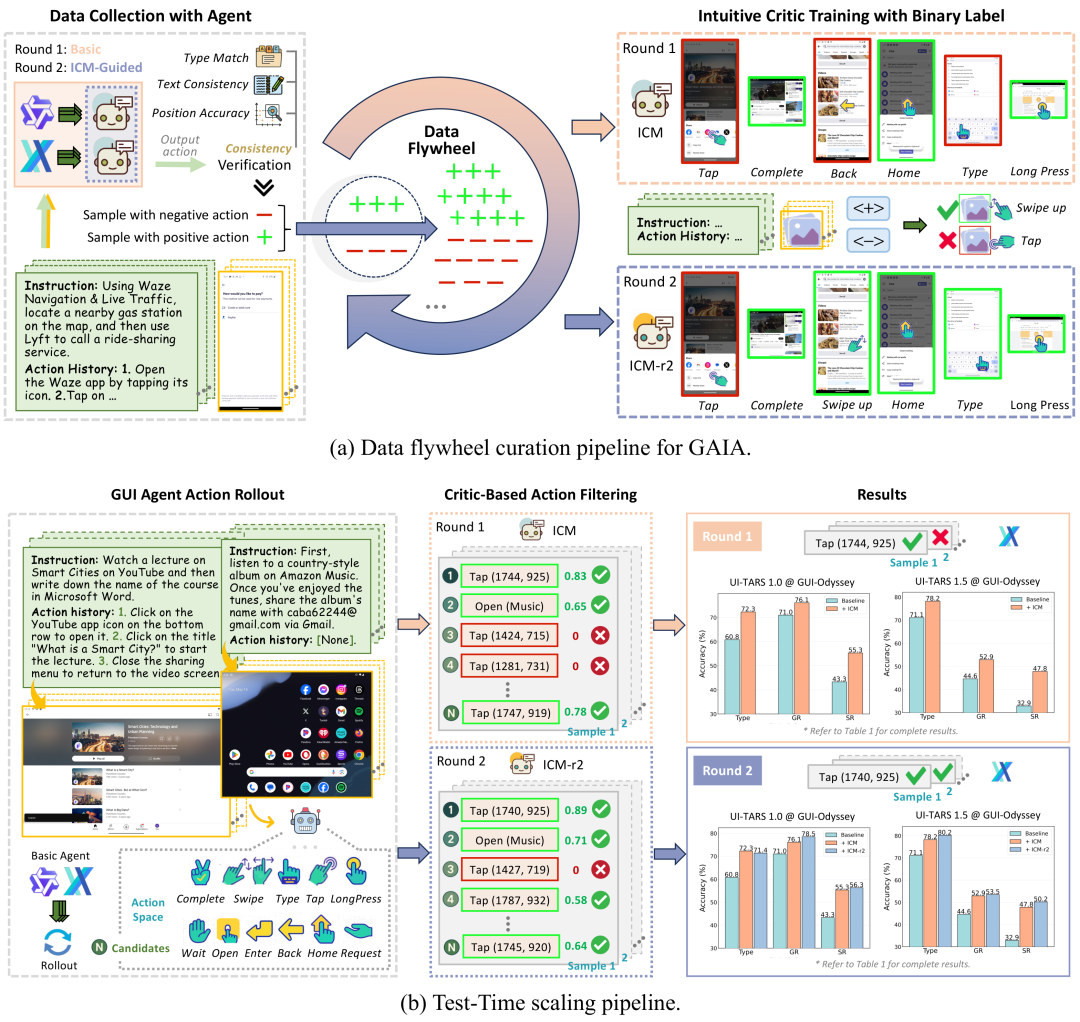
▎GAIA: A Data Flywheel System for Training GUI Test-Time Scaling Critic Models
论文作者:王劭康,付培,张若嶒,张少杰,席修文,杨家辉,秦斌,黄英,罗振波,栾剑
论文链接: https://arxiv.org/abs/2601.18197
代码链接: https://github.com/SeerRay-Lab/GAIA
从 OpenAI Operator 到 Google Project Mariner,再到各类“AI 帮你操作手机”的 demo,GUI Agent 已成为行业重点方向。但 GUI 操作具有不可逆性,一次错误点击可能直接中断任务流程。因此,Agent 不仅要会操作,还要在动作执行前知道“该不该点”。
GAIA 提出基于数据飞轮的直觉判别模型训练框架,从真实 Agent 交互中构建高质量正负样本,训练轻量级 Critic Model。在推理阶段,模型通过多候选动作采样与 Critic 筛选实现 Test-Time Scaling;同时,利用 Critic 挖掘困难样本回流训练,形成"数据—模型—数据"的闭环。
实验表明,该方法在多个 GUI 基准上为开源与闭源模型带来稳定提升,任务成功率最高提升超过 10%。更关键的是,ICM/ICM-v2 仅需单 token 即可完成判断,相比推理型模型显著降低开销。该工作为 GUI Agent 的动作评判、推理时增强和可靠性提升提供了一条低成本、可扩展的技术路径。
▎UniTranslator: A Unified Multi-modal Framework for End-to-End In-Image Machine Translation
合作者单位:中国科学院信息工程研究所、南开大学、宾汉姆顿大学
论文作者:吕嘉昊,付培,李祯航,张少杰,杨佳辉,周宇,马灿,罗振波,栾剑
论文链接: https://arxiv.org/abs/2606.24333
代码链接: https://github.com/SeerRay-Lab/Unitranslator
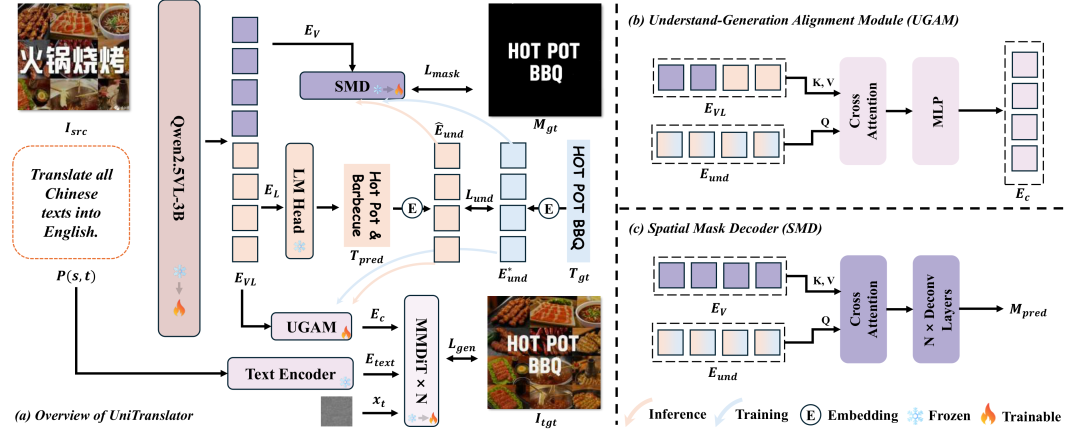
出国旅行拍一张外文菜单,AI 直接把翻译结果“画”回图片里,保持原有排版和空间位置——这是图像内机器翻译的理想形态。相比传统 OCR、翻译、贴图的管线式方案,端到端 IIMT 需要模型同时理解文字语义、图像布局和视觉生成。这面临两大核心挑战:翻译语义理解与图像像素生成之间存在显著的表示鸿沟(语义不一致),以及生成的翻译文本与目标区域之间的空间对齐困难(几何错位)。
UniTranslator 针对这两个瓶颈分别设计了解决方案。针对语义不一致问题,提出理解-生成对齐模块,通过对齐损失和共享表示空间缩小翻译理解模块与图像生成模块之间的语义鸿沟;针对几何错位问题,引入空间掩码解码器,利用精确的文本区域掩码作为空间约束,引导生成模型仅在正确位置渲染翻译文本,同时保持原始图像的非文本区域完整无损。整套框架实现了从输入图像到翻译后图像的端到端生成,无需中间的 OCR 检测、文本擦除、字体匹配等复杂步骤。
在多个公开基准和语言方向上,UniTranslator 均取得领先性能。这说明,统一多模态框架能够有效打通翻译理解与图像生成之间的鸿沟,为端到端图像内机器翻译和复杂场景文本编辑提供了重要技术参考。
▎ELVA: Exploring Ranking-Driven Universal Multimodal Retrieval
*表示共同第一作者
论文作者:刘雨涵*,付培*,李航,祁禹坤,姜超,付靖文,刘振,秦斌,罗振波,栾剑,辛景民
论文链接: https://arxiv.org/pdf/2606.20280
代码链接: https://github.com/SeerRay-Lab/ELVA
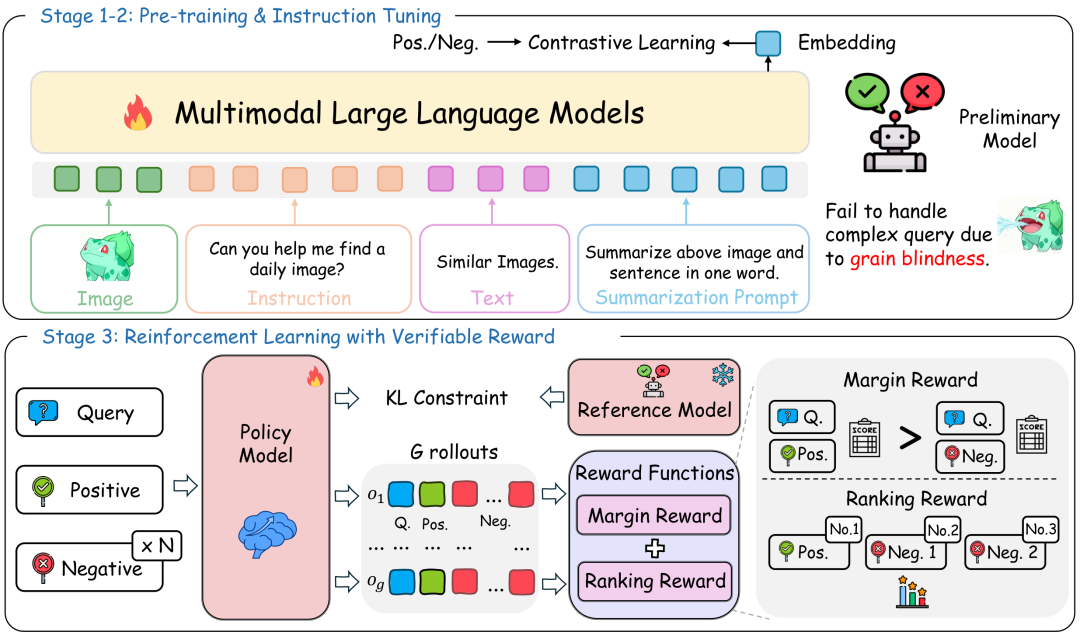
“帮我找那张穿红衣服在海边跑步的照片。”这类查询包含主体、属性、动作和场景,是多模态检索模型的真正考验。现有方法在训练过程中,模型倾向于只关注图像中最显眼的主体对象(比如“人”、“狗”、“车”),而忽略动作(跑步 vs 站立)、属性(红衣服 vs 蓝衣服)和关系(在海边 vs 在公园)等细粒度信息。本文将这一普遍存在的现象命名为“粒度盲区”(Grain Blindness),并指出其根源在于传统对比学习目标缺乏对多粒度语义的显式建模。
为解决粒度盲区问题,本文提出了 ELVA,将排序思想引入多模态检索训练,不再只优化“相关/不相关”的二元判断,而是通过可验证奖励引导模型学习候选结果之间的相关性排序。模型需要判断“穿红衣服在海边跑步”比“穿红衣服在公园站着”更相关,从而被迫理解查询中的多粒度语义。
实验表明,ELVA 在 M-BEIR 通用多模态检索基准上取得领先表现;在多粒度检索基准 MRBench 上,相比 LamRA-Ret-7B 提升 13.1%。该工作为通用多模态检索、多粒度语义理解和复杂查询匹配提供了新的训练范式与技术支撑。
03
自动驾驶,从“看见道路”到“理解世界”
自动驾驶不只是识别车道线、车辆和行人,更要理解交通参与者之间的互动,预测未来场景变化,并在关键决策点提前纠错。本次入选 ECCV 2026 的论文,覆盖世界模型、具身导航、在线强化学习、视频动作模型、安全学习和主动干预等前沿方向,为自动驾驶世界模型、VLA 决策、安全规划与鲁棒控制等关键问题提供了系统性的技术探索。
▎CausalDrive: Real-time Causal World Models for Autonomous Driving
*表示共同第一作者,†表示通讯作者
论文作者:闫天翊*,郑欢*,陈督冰*,曲美至,申影影,周丽君,涂鸣非,王兵,陈光,叶航军,孙海洋,须成忠†,沈建冰†
论文链接: https://arxiv.org/pdf/2606.15341
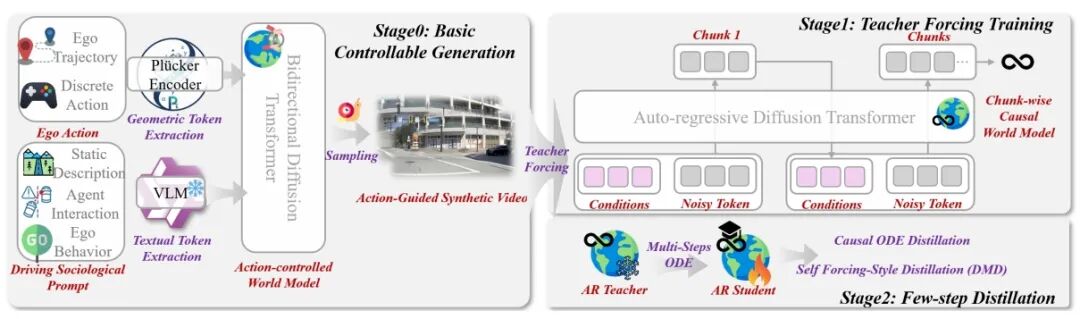
现有驾驶世界模型大多把未来预测当成视频生成任务,但交通场景的核心不只是像素变化,而是参与者之间的因果交互。一辆车刹车,后车为什么减速?这不是简单相关性,而是因果关系。
CausalDrive 提出实时因果世界模型,仅凭前视画面、自车轨迹和文本提示,在屏蔽背景车辆未来信息的前提下,迫使模型学习交通参与者之间的因果交互。该工作设计 Context-Forced DMD 架构,结合连续流匹配与自纠正蒸馏,实现 12 FPS 的实时交互式模拟。这标志着自动驾驶世界模型从单纯“视频生成”迈向“社会交互模拟”。
▎Pondering the Way: Spatial-perceiving World Action Model for Embodied Navigation
论文作者:陈红,刘达祺,张泽瀚,王海光,卢天浩,颜龙飞,孙海洋,李方震,谢宏伟,王兵,陈光,叶航军,谭毅华
论文链接: https://arxiv.org/abs/2606.29908
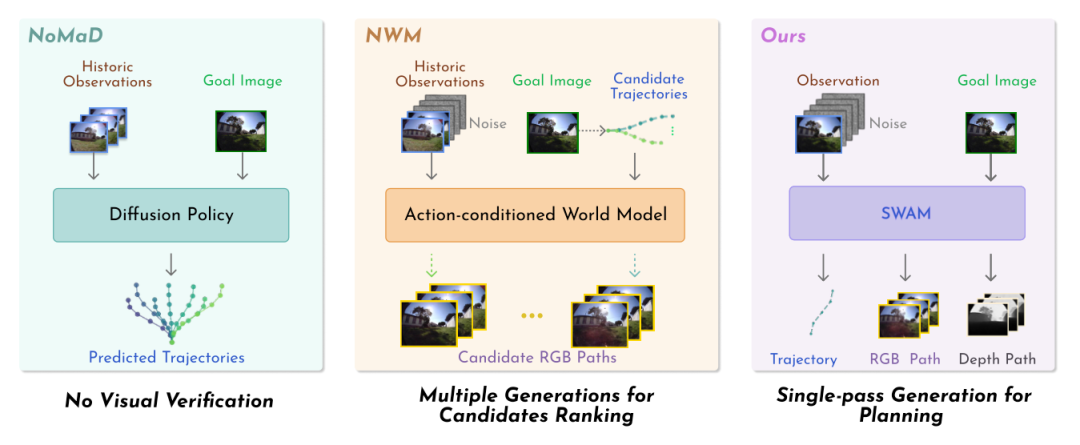
具身导航的关键,不只是知道目标在哪,还要理解空间结构,并规划如何到达。现有方法常采用“先采样候选动作、再预测未来视频验证”的两阶段范式,容易受到候选轨迹覆盖不足、推理开销大、动作与视觉预测不一致等问题限制。
SWAM 提出空间感知世界动作模型,在单次前向推理中联合生成中间 RGB-D 视觉路径和对应动作轨迹,将目标意图、视觉演化和运动规划统一到同一生成过程中。方法利用 DepthAnything V3 提供深度伪标签进行空间感知训练,推理时仅需单目 RGB 输入,并在 RECON、SCAND、TartanDrive 等数据集上取得更优表现。
▎MindDrive: A Vision-Language-Action Model for Autonomous Driving via Online Reinforcement Learning
*表示共同第一作者
论文作者:付好宇*,张点堃*,赵宗闯,崔剑锋,谢宏伟,王兵,陈光,叶航军,梁定康,白翔
论文链接: https://arxiv.org/pdf/2512.13636
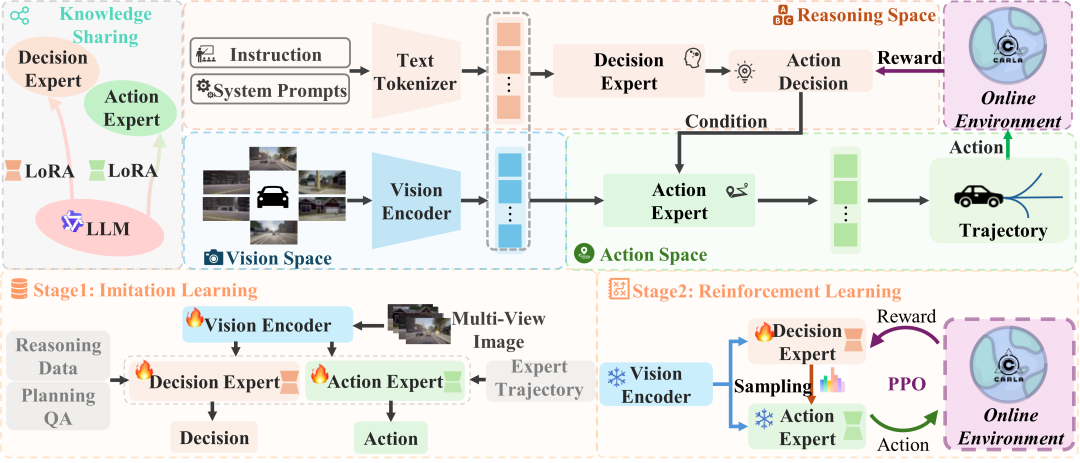
将大语言模型应用于自动驾驶决策(VLA 模型)是当前的热门方向,但现有方法几乎全部依赖离线模仿学习——从专家驾驶数据中学习复制行为。这导致模型只能模仿见过的场景,难以应对分布外的长尾情况。在线强化学习虽然能通过试错持续提升,但在连续动作空间的驾驶任务上极难收敛。
MindDrive 巧妙地绕过了这一难题:采用共享基座、双 LoRA 的 LLM 架构,其中决策专家将驾驶场景理解为离散的语言指令(如“缓慢左转避让行人”),动作专家再将语言指令映射为精确的轨迹点。关键创新在于:将动作执行后获得的环境奖励反馈至语言决策层,在离散的语言空间中完成试错优化——这比在连续轨迹空间中做 RL 要高效稳定得多。实验验证了在线强化学习在自动驾驶 VLA 模型上的有效性,为“驾驶模型在部署后持续进化”开辟了可行路径。
▎DriveVA: Video Action Models are Zero-Shot Drivers
*表示共同第一作者
论文作者:刘蒙蒙*,张点堃,刘久铭,崔剑锋,谢宏伟,陈光,叶航军,Michael Ying Yang,Francesco Nex,程浩
论文链接: https://arxiv.org/abs/2604.04198
自动驾驶模型要真正部署到真实环境中,关键挑战之一是泛化能力。也就是说,模型不能只在见过的数据上表现好,还要能适应未见过的场景、传感器域和环境条件。现有方法中,未来画面预测和动作轨迹规划往往是分开完成的,这容易导致模型“预测出来的未来场景”和“规划出来的行驶轨迹”不够一致。
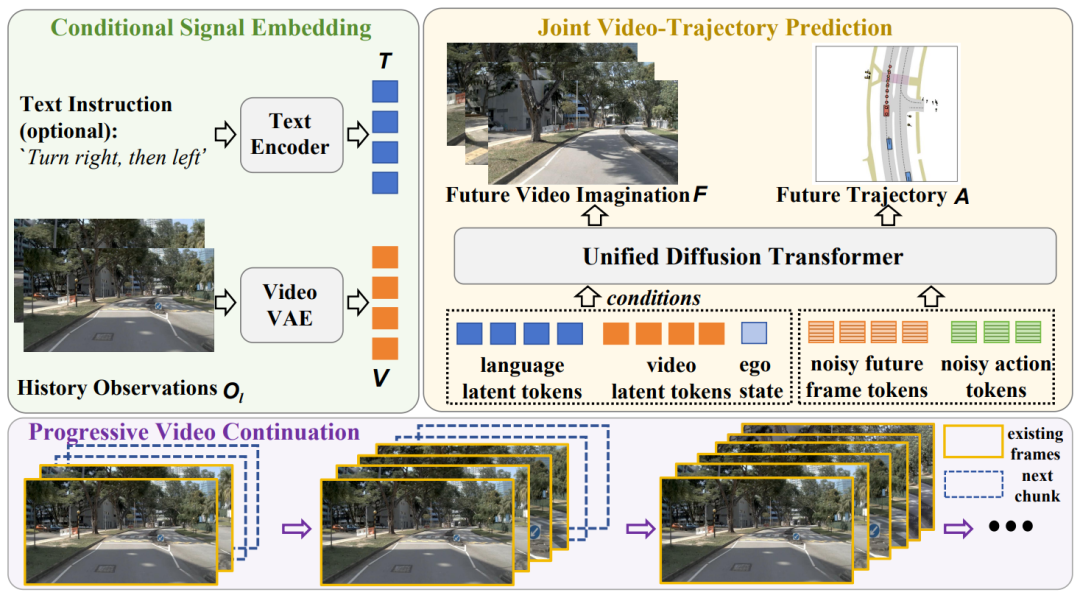
DriveVA 提出统一的视频-动作自动驾驶世界模型,将未来视觉预测与动作轨迹生成放入共享的 latent generative process 中,让规划轨迹与模型想象出的未来场景演化共同产生。具体来说,DriveVA 基于大规模预训练视频生成模型,继承其对时空动态、物理合理性和因果交互的建模先验,并采用统一的 DiT-based decoder,同时生成未来视频 latents 和车辆 action tokens。此外,DriveVA 还引入 progressive video continuation 机制,以递归方式进行长时序视频续写,从而提升闭环规划过程中的长期一致性。
实验表明,DriveVA 在 NAVSIM v1 上取得 90.9 PDMS 的闭环驾驶性能,并在 zero-shot 设置下展现出强跨域泛化能力:仅在 NAVSIM 上训练后,即可直接泛化到 nuScenes 和 Bench2Drive/CARLA,无需目标域微调,并显著降低轨迹误差和碰撞率。这验证了大规模视频生成先验与统一 video-action 建模在自动驾驶泛化规划中的有效性。
▎Beyond Imitation: Learning Safe End-to-end Autonomous Driving from Hard Negatives
论文作者:王君礼,花志华,刘学义,邢泽斌,张威,马昆,陈光,叶航军,陈龙,张启超
论文链接: https://arxiv.org/abs/2605.19771
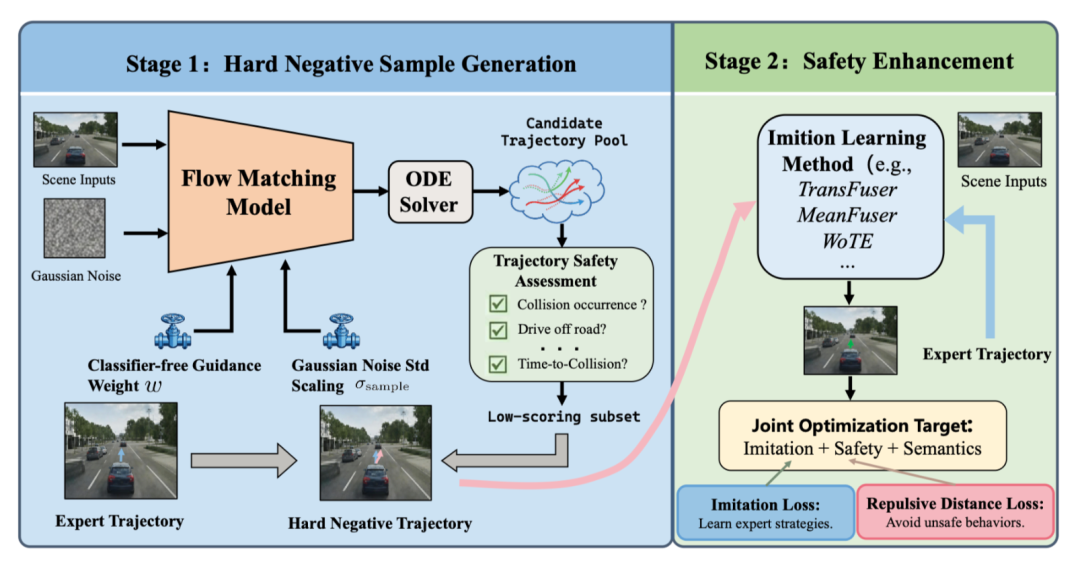
模仿学习的根本局限在于:模型只见过“正确的驾驶行为”,却从未见过“错误但看起来很接近正确的行为”。这就像一个学生只做对的题,从不分析错题——他可能知道正确答案长什么样,但不知道陷阱在哪里。
BeyondDrive 针对这一问题,引入“从失败行为中学习”的机制。方法通过流匹配模型主动生成具有挑战性的高质量负样本,这些负样本在空间上接近专家轨迹,但在语义上并不安全。进一步地,BeyondDrive 通过反向距离误差损失约束,引导模型在靠近专家轨迹的同时,主动远离危险负样本区域,从而增强驾驶行为的安全性。
实验表明,BeyondDrive 可应用于单模态端到端方法和多类多模态端到端方法,并均取得显著性能提升,其中 NAVSIMv2 EPDMS 达到 90.1。这说明,通过困难负样本帮助模型建立更清晰的安全边界,是提升端到端自动驾驶安全性的一条有效路径。
▎DriveFine: Refining-Augmented Masked Diffusion VLA for Efficient and Robust Driving
论文作者:党晨旭,昂思宁,李永康,田浩辰,王杰,李广,叶航军,马杰,陈龙,王岩
论文链接: https://arxiv.org/abs/2602.14577
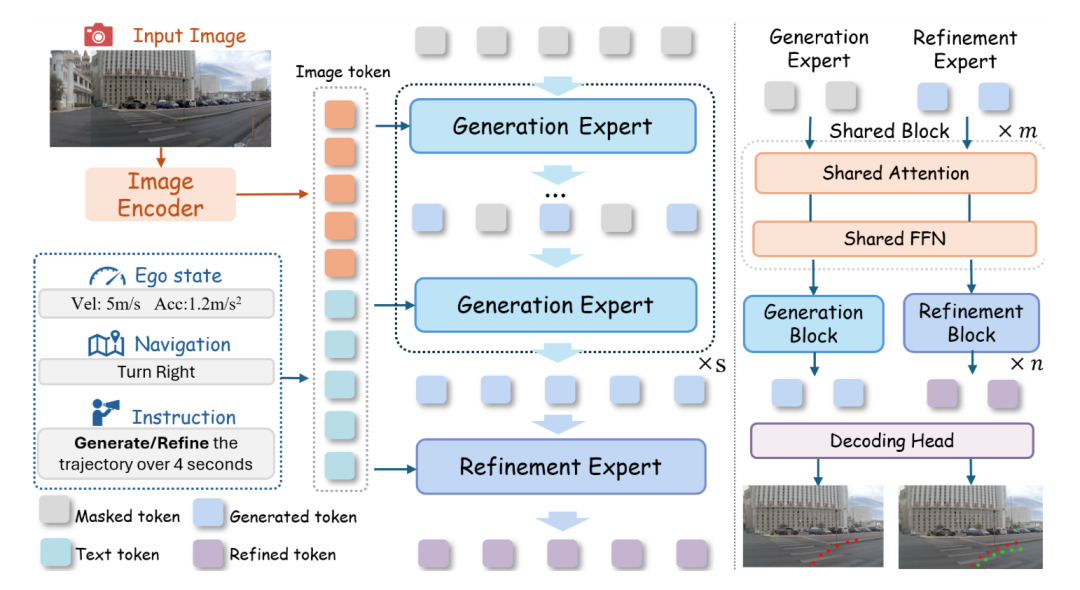
端到端自动驾驶正在从传统模块化架构走向生成式规划,但现有路线仍各有短板:连续扩散策略容易出现跨模态对齐不足、泛化能力有限等问题;离散 Token 形式的 VLA 模型虽然更适合接入大语言模型能力,但一旦解码出错,往往难以回头修正,容易造成误差累积。
DriveFine 提出了一种基于掩码扩散大语言模型的视觉-语言-动作规划框架,将轨迹规划建模为可迭代优化的生成过程。为解决 Token 解码不可逆的问题,DriveFine 引入即插即用的块级混合专家模块,以较低成本为模型注入 Refinement 自我优化能力,并通过显式专家路由与梯度隔离,实现轨迹生成与轨迹优化的解耦。
实验表明,DriveFine 在 NAVSIM v1、NAVSIM v2 以及更具挑战性的 Navhard 基准上,均展现出良好的性能、鲁棒性与效率。通俗地说,它让自动驾驶规划模型不再只是“一次性作答”,而是具备“先生成、再修正”的能力,有助于端到端驾驶系统在复杂路况和长尾场景中做出更稳、更可靠的规划决策。
-
论文的价值,不只在于被顶会录用,更在于它是否能沉淀为持续可复用的技术能力。对小米来说,这些论文所展示的,不是某个单点方向的突破,而是围绕智能终端、智能汽车和智能生活场景展开的系统性技术积累。
视觉理解与生成,让设备更懂真实世界中的图像与视频;GUI Agent、图像内翻译和多模态检索,让大模型更接近用户的真实任务;自动驾驶世界模型与 VLA 研究,则让车辆具备更强的预测、决策和自我修正能力。它们共同指向的,不是单点功能的升级,而是小米 AI 能力体系的持续生长。
对小米而言,论文不是终点,而是技术进入产品之前的一次公开验证。每一项研究背后,都是对更高效模型、更可靠交互、更安全决策和更自然智能体验的长期投入。未来,这些能力将继续沉淀到手机、汽车、智能家居等核心场景中,成为用户真实可感知的体验进化。