10万小时训出“开箱即用”机器人基座模型:Xiaomi-Robotics-1 探索具身智能 Scaling 效应
2026-08-06
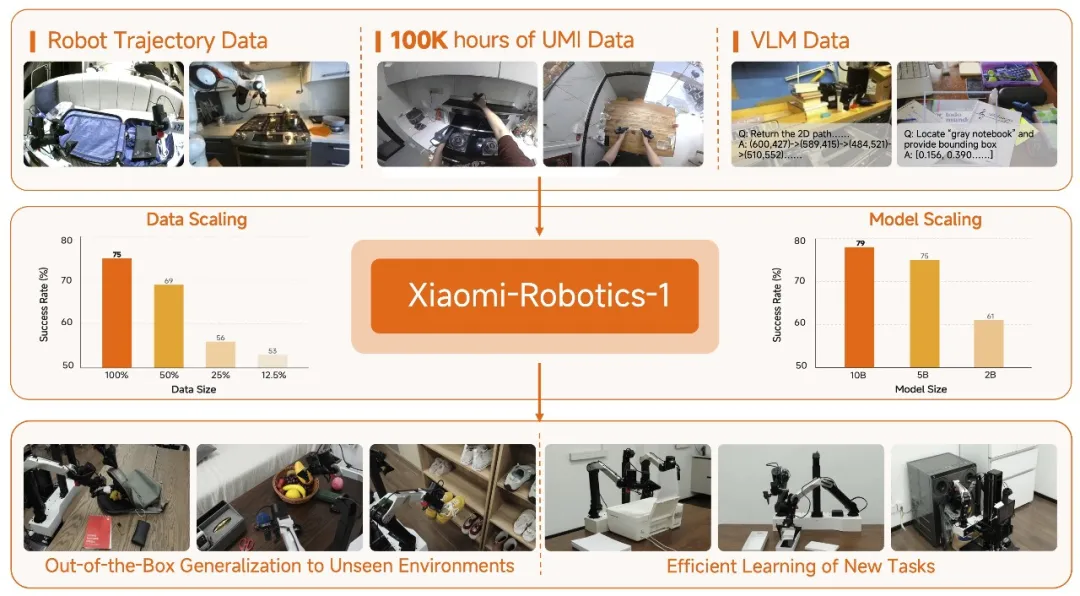
2026年7月16日,我们发布 Xiaomi-Robotics-1,一个面向真实移动操作任务的具身基座模型。模型基于10万小时真实世界数据进行预训练,并结合跨本体数据完成后训练,在未见环境真实机器人任务中展现稳定的规模化收益、在复杂新任务适配和多个仿真基准中展现出强大的性能。
项目主页:https://robotics.xiaomi.com/xiaomi-robotics-1.html
01
机器人策略模型,也能进入 Scaling Law 时代吗?
过去几年,大语言模型和视觉语言模型的快速发展证明了一件事:当数据规模、模型容量和训练计算量持续提升,模型能力往往会呈现可预测的增长趋势。
但在机器人领域,这条路径并不容易复制。
机器人要学习的不只是“看懂”和“说清”,还要在真实物理世界中完成动作。真实机器人数据采集依赖具体硬件、真实环境和人工遥操作,成本高、周期长、规模有限。更重要的是,传统机器人数据往往集中在少量场景和少量任务上,难以支撑策略模型获得足够强的泛化能力。
因此,一个关键问题始终存在:
如果机器人策略模型也能获得足够大规模、足够多样化的真实世界操作数据,它是否也能像大模型一样持续 Scaling?
Xiaomi-Robotics-1 正是围绕这一问题展开的系统性探索。
02
10万小时真实世界轨迹,突破机器人数据瓶颈
想要验证 Scaling Law 需要足够量级的数据支撑,但大量数据采集这件事本身就很有挑战,Xiaomi-Robotics-1 的第一步,就是克服预训练数据规模的困难。
在预训练阶段,团队使用了 10万 小时真实世界操作轨迹。这些数据通过 Universal Manipulation Interface(UMI)设备采集,覆盖家庭、商业空间、工业场景、办公室、户外等多类环境,包含大量物体交互和操作行为。
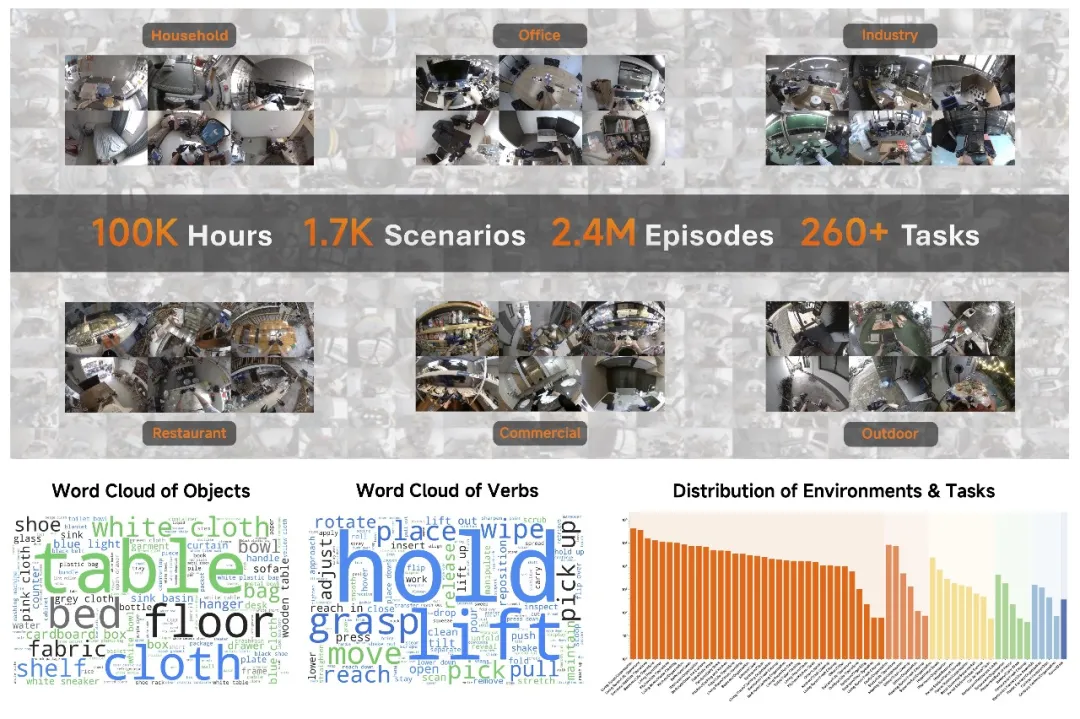
UMI 数据的优势在于不依赖特定机器人本体,同时能够更高效地采集真实世界中的操作过程。模型可以先从大规模真实操作轨迹中学习通用的动作生成表征,再在后续阶段迁移到真实机器人上。
面对 10万 小时数据,传统人工方式难以支撑高效处理。为此,团队构建了可规模化的自动标注流程:将长轨迹切分为固定长度片段,并使用视觉语言模型对片段中的夹爪状态变化和交互物体状态变化进行描述。模型由此学习在当前视觉观察和语言条件下,生成能够推动场景状态变化的动作。该自动标注流程效率非常高,可在大约 2 周内完成全量 10 万小时数据的高质量标注。
03
两阶段训练:从通用动作生成,到真实机器人执行
Xiaomi-Robotics-1 采用 预训练 + 后训练 的两阶段训练范式。
在预训练阶段,模型学习的是通用动作生成能力。给定当前视觉观察和语言描述,模型需要预测一段动作序列,使场景从当前状态向目标状态变化。
后训练阶段则重点解决两个对齐问题:
第一,本体对齐。
将预训练阶段从 UMI 数据中获得的动作生成能力,迁移到真实机器人本体上。
第二,指令对齐。
将“根据状态变化描述生成动作”的能力,转化为“根据人类自然语言指令执行任务”的能力。
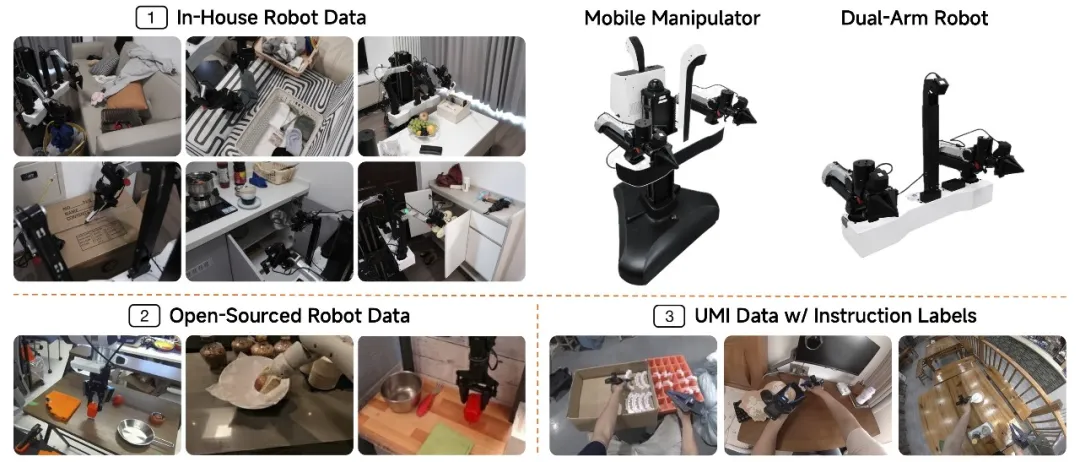
为此,团队构建了约 10000 小时跨本体后训练数据,其中包括 7200+ 小时移动操作机器人和双臂机器人数据、1000+ 小时人工标注 UMI 数据,以及 Bridge V2、RT-1、DROID 等公开机器人数据集。
04
“开箱即用”能力
完成后训练后,Xiaomi-Robotics-1 即可在真实环境中,根据自然语言指令直接执行多类移动操作任务。
沙发整理
餐具收纳
05
数据更大、模型更大,动作预测更稳定
Xiaomi-Robotics-1 的核心结果之一,是在预训练阶段观察到清晰的规模化趋势。
在数据规模实验中,团队分别使用 2.5K、5K、10K、20K 小时 UMI 数据进行训练。结果显示,随着预训练数据规模增加,模型在验证集上的动作预测损失持续降低。较小数据规模下,模型更容易出现过拟合;更大数据规模下,训练过程则更加稳定。
在模型规模实验中,团队对比了 2B、5B、10B 三个参数规模版本。结果同样表明,随着模型规模提升,动作预测能力持续改善。
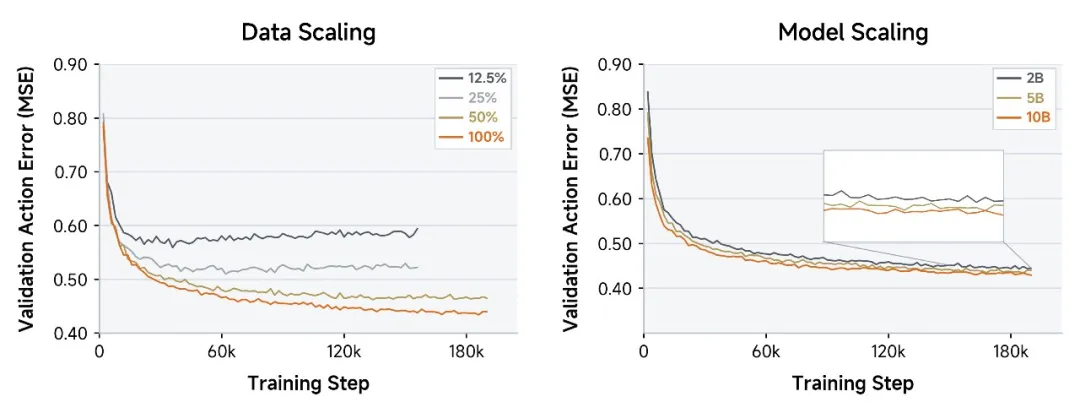 在预训练的实验中,随着训练数据量(左图)和模型尺寸(右图)的不断增加,验证集上动作预测的精度不断提升
这说明,对于机器人策略模型而言,扩大真实世界操作数据和模型容量,能够带来可观测的性能收益。更重要的是,这一收益并不只体现在离线指标上。后续真实机器人实验表明,预训练阶段更强的模型,在后训练后的真实任务执行中也表现更好。
真实机器人评测覆盖鞋柜收纳、书包打包、桌面整理、沙发收拾等任务,重点考察模型在新环境、新物体条件下 out-of-the-box (“开箱即用”)的表现,而不是针对单一测试环境进行任务微调。
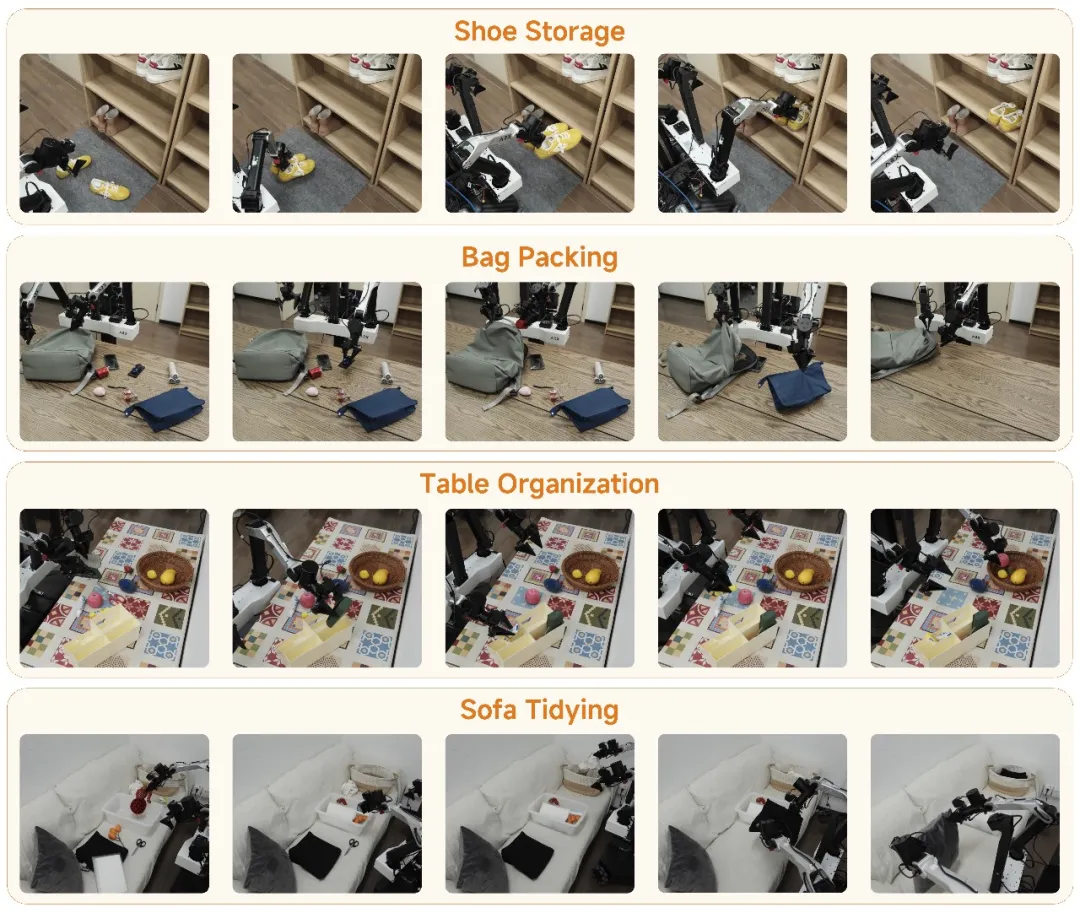
实验结果显示,预训练阶段表现更好的模型,在后训练后的真实机器人评测中也取得更好的任务成功率。这说明,大规模预训练获得的通用表征,能够迁移到真实机器人执行中。
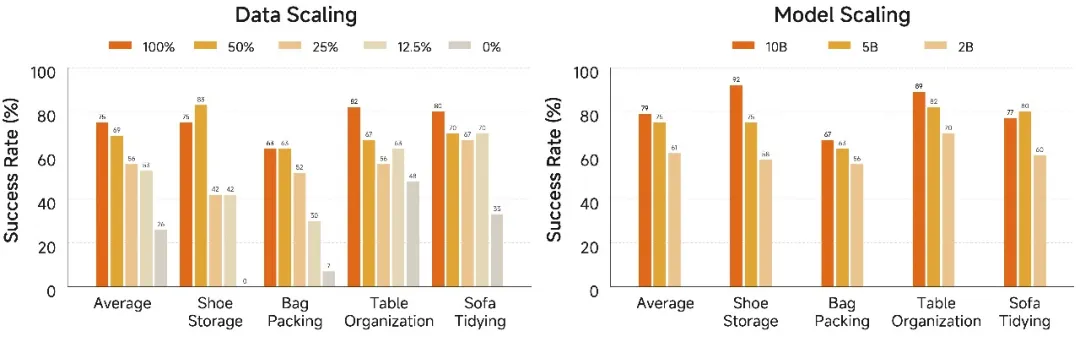 在后训练的实验中,随着预训练数据量(左图)和模型尺寸(右图)的不断增加,模型在未见过场景完成任务的成功率不断提升
这对于机器人学习具有重要意义:模型不必完全依赖昂贵、稀缺的真机数据从零开始训练,而可以先通过大规模无本体操作轨迹获得基础能力,再通过高质量机器人数据完成本体和指令对齐。
06
少量数据适配复杂新任务
作为机器人基座模型,Xiaomi-Robotics-1 不只关注已有任务表现,也关注新任务适配的效率。
在复杂、灵巧操作任务上,模型可以通过少量下游真实机器人数据进行高效微调,而不是从零开始学习。这种“先训练通用基座,再用少量数据适配任务”的方式,有助于降低新任务开发的数据成本和训练成本。
在每个任务平均数据时长不足10小时的条件下,Xiaomi-Robotics-1 在四个任务中均大幅超越 Pi-0.5,这表明其具备更高的新任务学习效率。这也是机器人基座模型区别于传统单任务策略模型的重要价值:它提供的是一个可复用、可迁移、可持续扩展的能力起点。
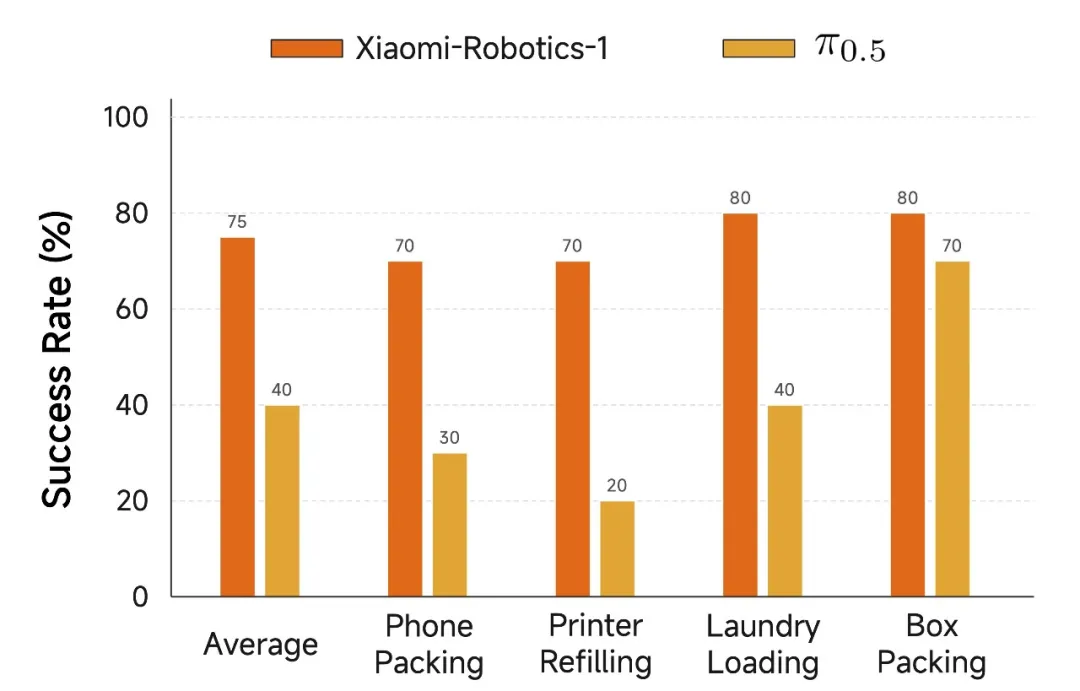 在新任务高效学习的实验中,Xiaomi-Robotics-1 在四个任务中的成功率都超越了 Pi-0.5
07
多个仿真基准达到领先结果
除真实机器人评测外,Xiaomi-Robotics-1 也在多个公开仿真基准上进行了验证。
在极具挑战性的 RoboCasa365 基准中,Xiaomi-Robotics-1 达到 57.4% 的平均成功率,相比此前最优方法 46.6% 取得很大提升。尤其在 Composite-Unseen 任务划分上,模型表现出强大的任务组合泛化能力。
在 RoboDojo 仿真评测中,Xiaomi-Robotics-1 以 20.07 的平均分数和 13.93% 的平均成功率强势登顶 Leaderboard,实现“断档式”领跑,大幅刷新了此前由行业最优方法保持的纪录(13.07分 / 8.80%成功率)。
在 VLABench 中,Xiaomi-Robotics-1 也取得了 state-of-the-art (SoTA) 的表现,平均成功率达到 59.1%,平均进度得分达到 70.3%。
在 RoboCasa 基准中,Xiaomi-Robotics-1 达到 74.5% 的平均成功率,超过 RLDX-1、Cosmos Policy、GR00T N1.6、Pi-0.5、Pi-0-FAST 等方法。
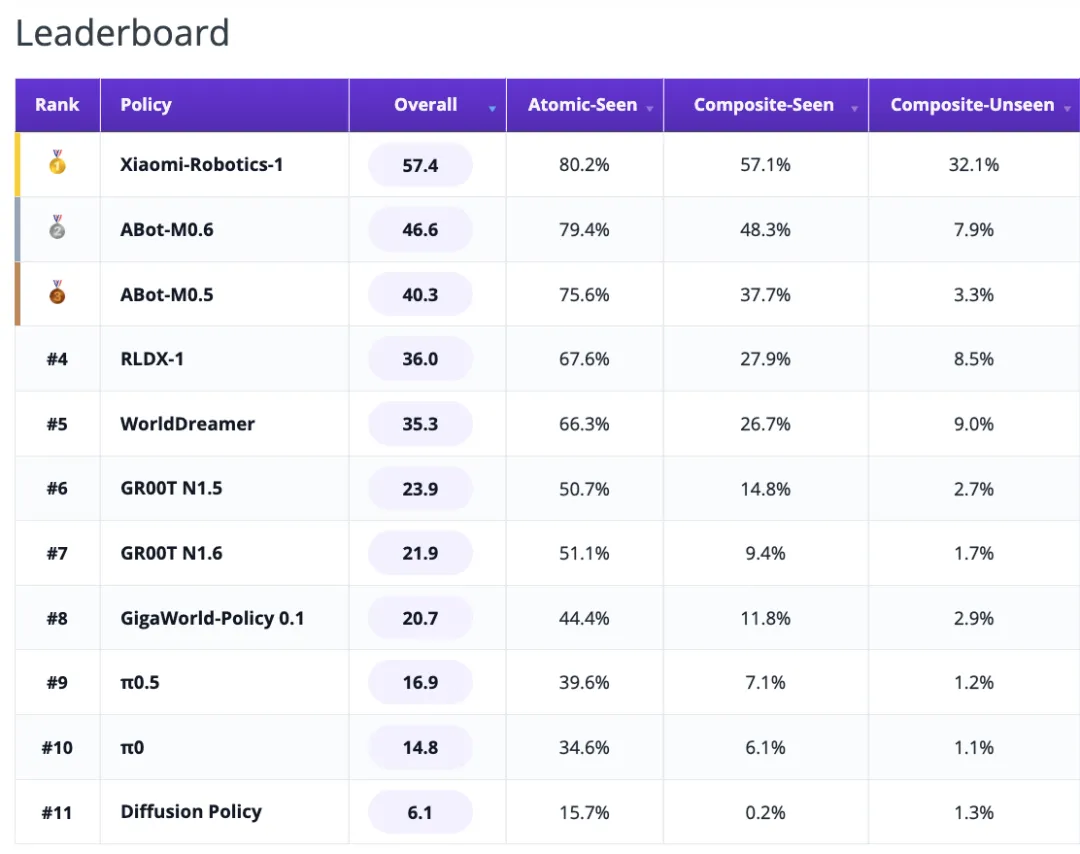 RoboCasa365 官网 Leaderboard 截图,Xiaomi-Robotics-1 排名第一(2026年7月15日)
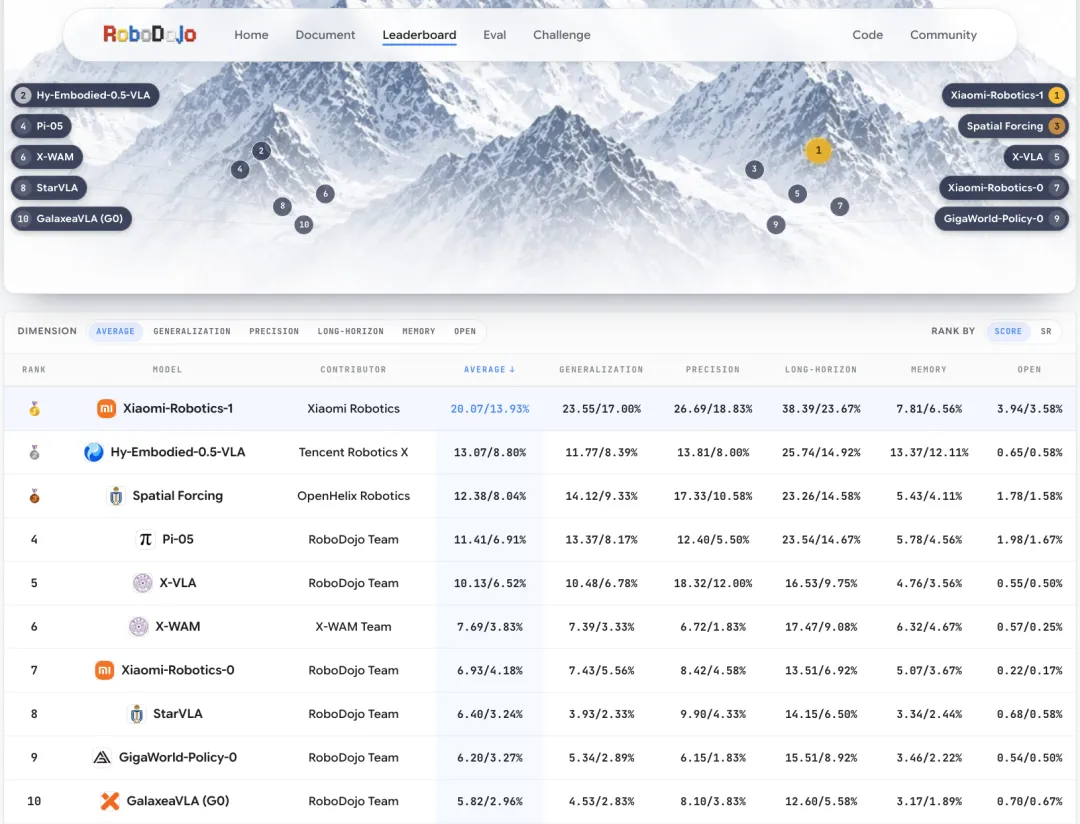 RoboDojo 官网 Leaderboard 截图,Xiaomi-Robotics-1 排名第一(2026年7月15日)
08
面向具身智能的可规模化训练路径
Xiaomi-Robotics-1 的意义,不只是完成了若干真实机器人任务,而是验证了一条面向具身智能的可规模化训练路径:
- 通过大规模预训练,学习通用动作生成表征;
- 通过跨本体机器人数据后训练,将能力迁移到真实机器人执行;
- 通过少量下游数据微调,快速适配复杂新任务。
这一路径表明,机器人策略模型有机会从过去依赖小规模、任务定制数据的训练方式,走向更接近基座模型的训练范式。
对于具身智能来说,Scaling Law 仍处在早期探索阶段。随着真实世界数据规模、模型规模和任务覆盖范围继续扩大,机器人基座模型的能力边界也将持续被拓展。
Xiaomi-Robotics-1 是小米机器人在这一方向上的一次系统性尝试。我们希望通过持续推进数据、模型和真实任务验证,让机器人从实验室演示走向更开放、更复杂的真实世界。
最后,一镜到底的全自主行李箱打包。
2026年8月5日,Xiaomi-Robotics-1 的代码与模型权重正式开源。
- 项目主页:https://robotics.xiaomi.com/xiaomi-robotics-1.html
- 代码仓库:https://github.com/XiaomiRobotics/Xiaomi-Robotics-1
- 模型权重:https://huggingface.co/collections/XiaomiRobotics/xiaomi-robotics-1
09
About Xiaomi Robotics
探索物理智能的边界,我们从不止步。
欢迎加入,一起在具身智能领域,触碰未来。