多模态感知理解技术:赋能全场景智能认知
2026-04-06
多模态感知理解技术,核心是打破文本、图像、视频、音频等各类多源数据的语义壁垒,通过统一建模与跨模态对齐融合,让机器具备视觉、听觉、文本阅读、场景感知与深度理解的综合认知能力。随着全场景智能设备快速普及,这项技术能够有效解决不同模态数据相互割裂的行业痛点,为智能感知与交互奠定核心基础。目前,我们的技术已在小米各产品线实现广泛应用,不断提升手机、可穿戴设备、汽车、音箱、家电等产品的用户体验。
01
通用多模态检索
在统一多模态检索领域,我们创新搭建通用多模态检索(UMR)训练方案,通过将视觉语言基础模型迭代转换为专属UMR模型,可将文本、图像、视频、音频、文档等多类数据统一映射至同一向量空间,搭建起适配各类复杂场景的通用认知基础。依托这一技术能力,设备可完成多模态数据的统一认知与关联匹配,彻底解决跨模态语义不互通的问题,为各类复杂场景的智能检索与内容理解提供核心支撑。
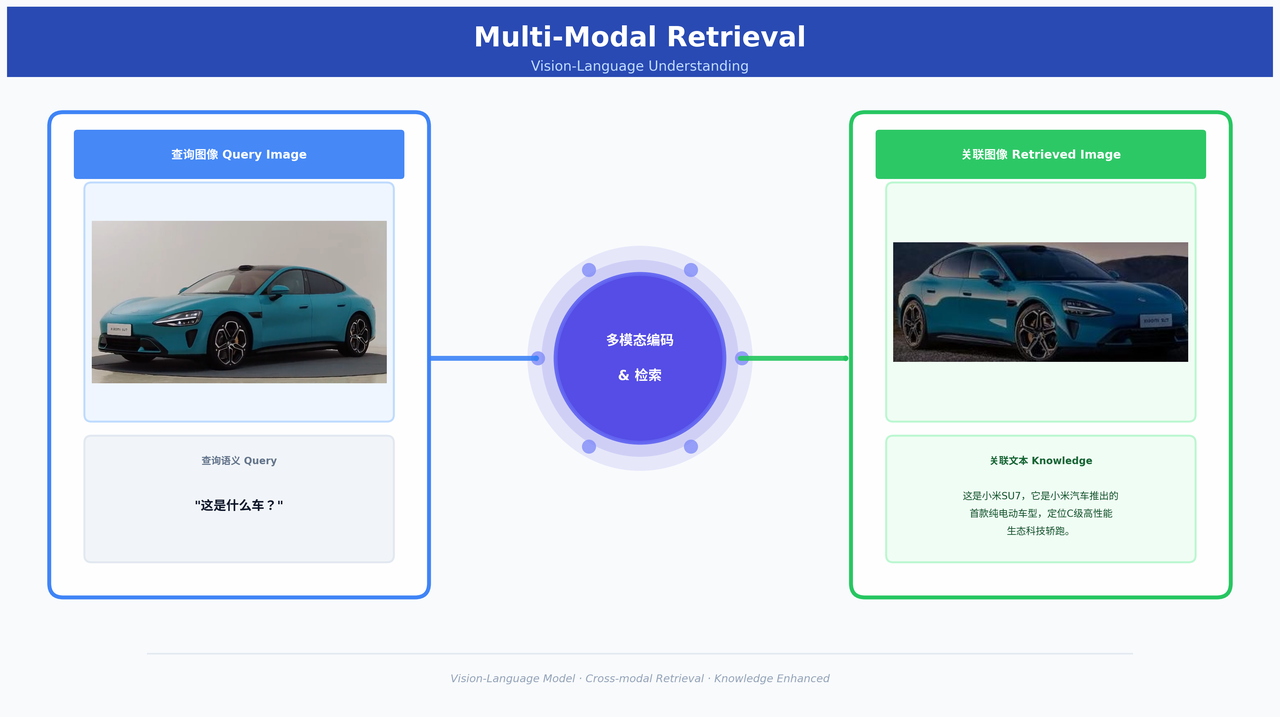 多模态检索
02
长视频深度理解推理
在长视频理解与推理领域,我们重点强化模型对复杂内容的深度解析能力,聚焦长视频时序建模、多模态空间信息结构化解析、跨模态语义精准建模等核心能力优化。
相较于传统模型仅能实现表层信息感知的短板,优化后的模型可完成复杂内容推理与长上下文深度理解,大幅提升机器对真实物理世界复杂场景的处理能力,适配各类高精度视频内容分析场景。
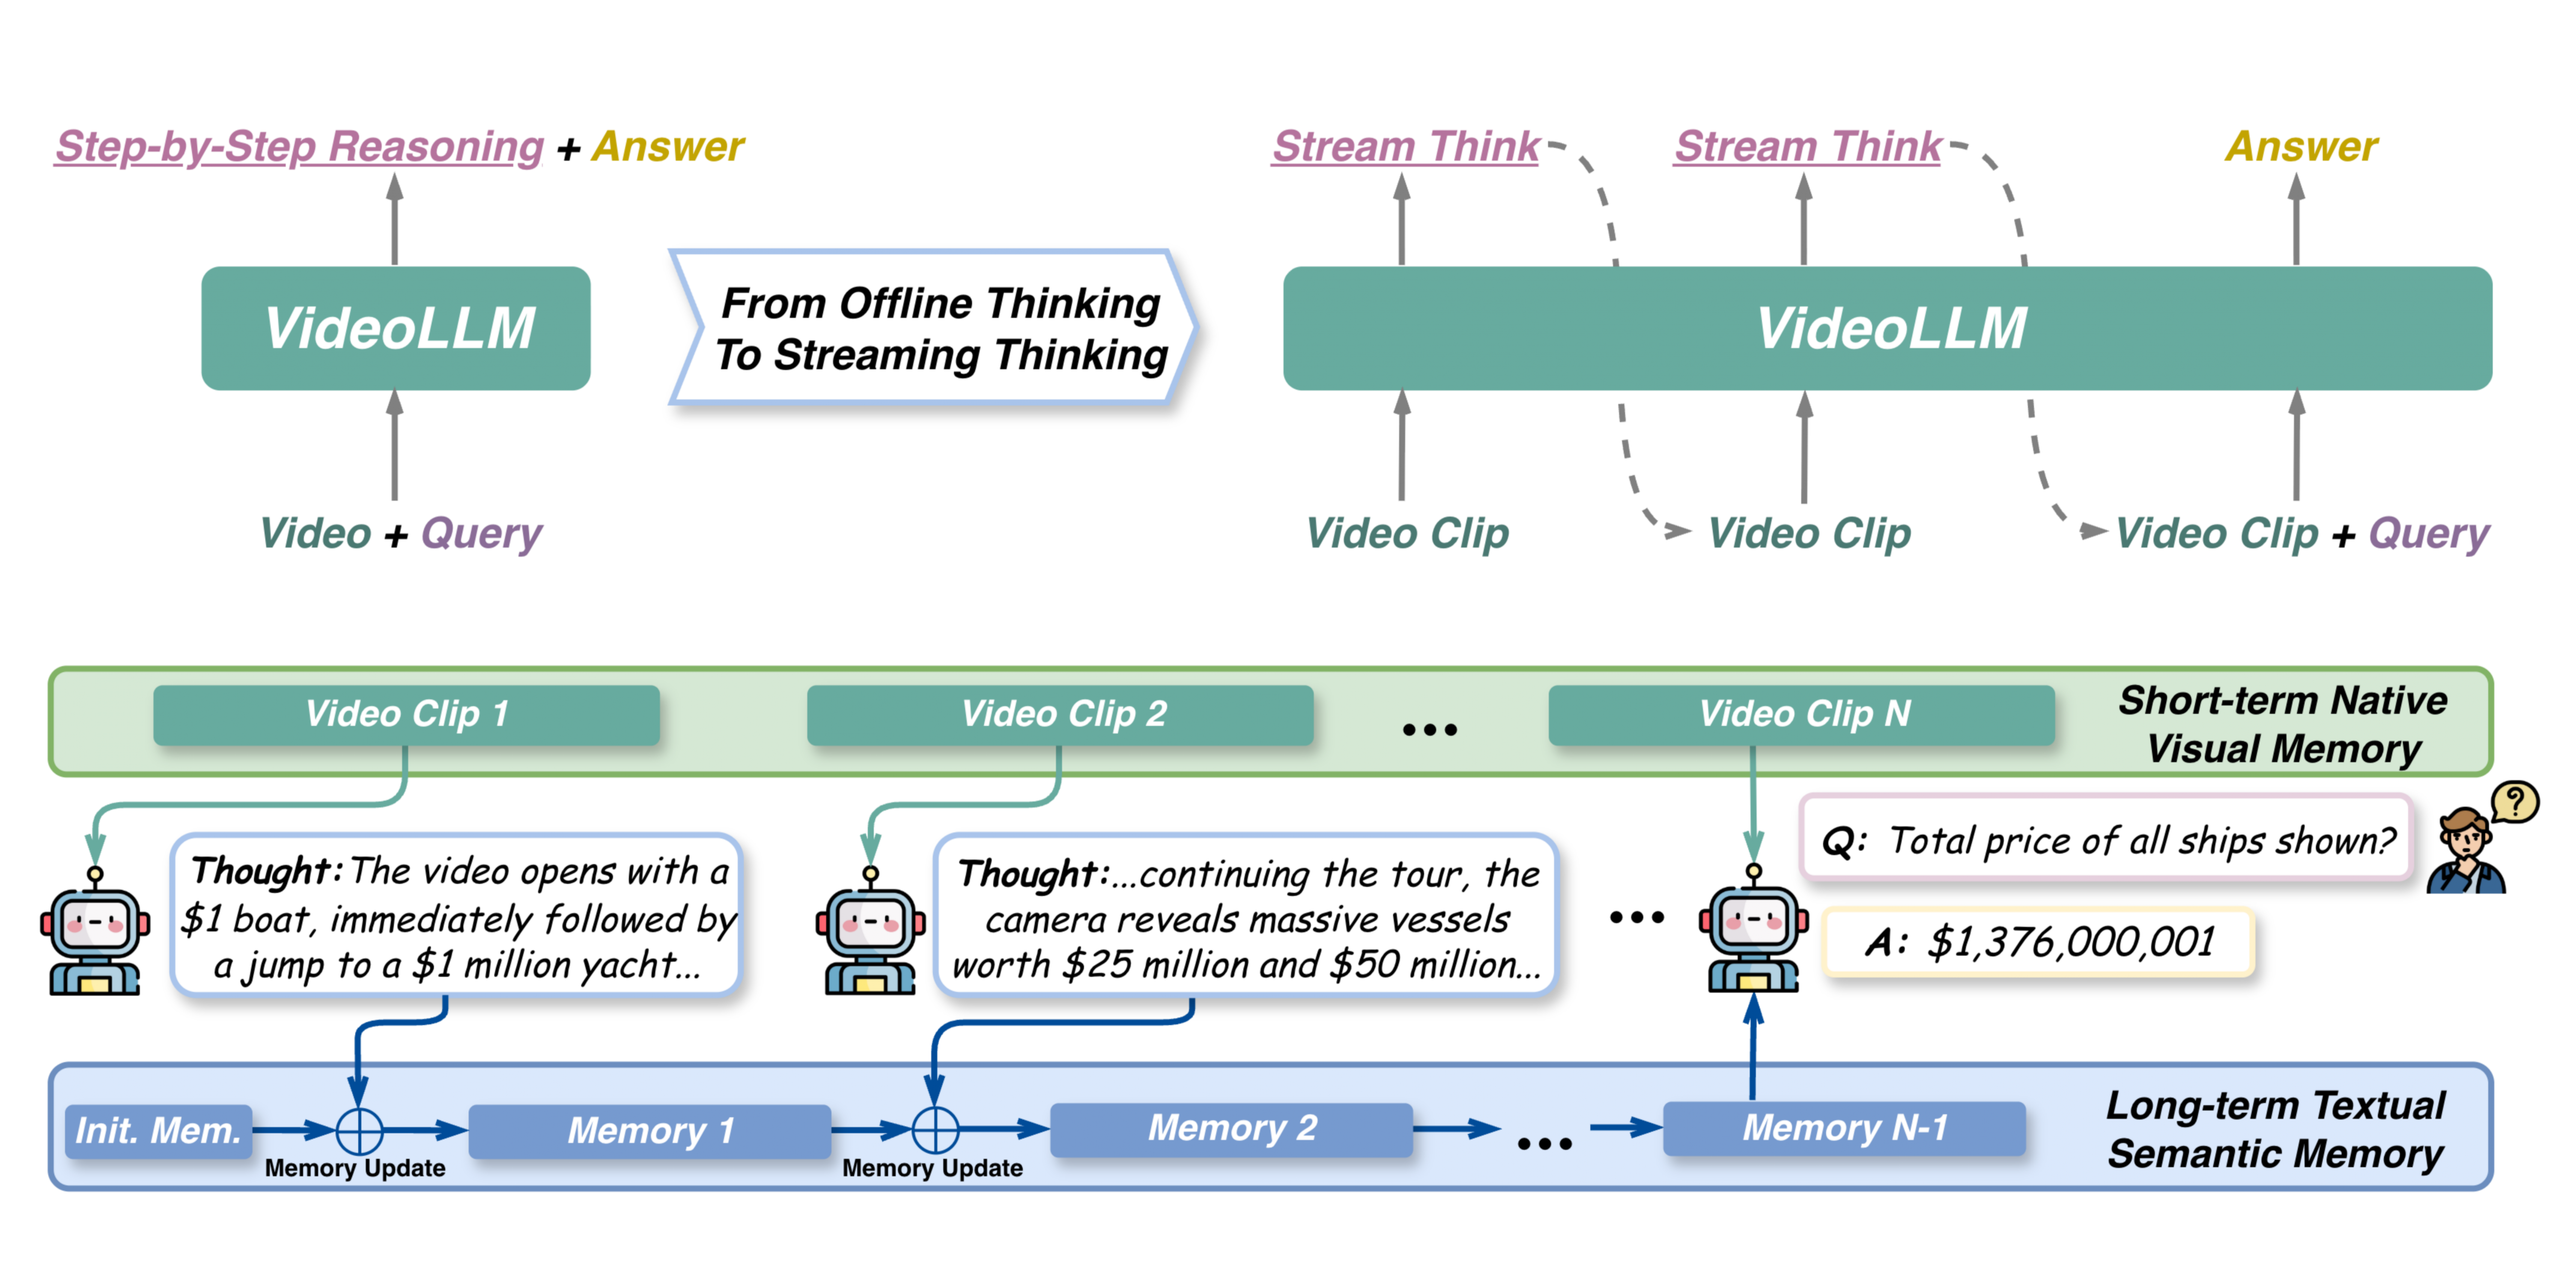 视频理解
03
多模态文档智能解析
在多模态文档解析领域,我们结合大模型语义能力与传统OCR技术优势,针对包含文字、图片、表格、印章、手写批注的复合型文档,实现全自动智能识别与深度理解。该技术可将非结构化的复杂文档内容,自动转化为结构化、可检索、可复用的标准化信息,有效解决传统文档识别技术能力单一、无法融合理解多元素内容的问题,大幅提升文档处理智能化水平。
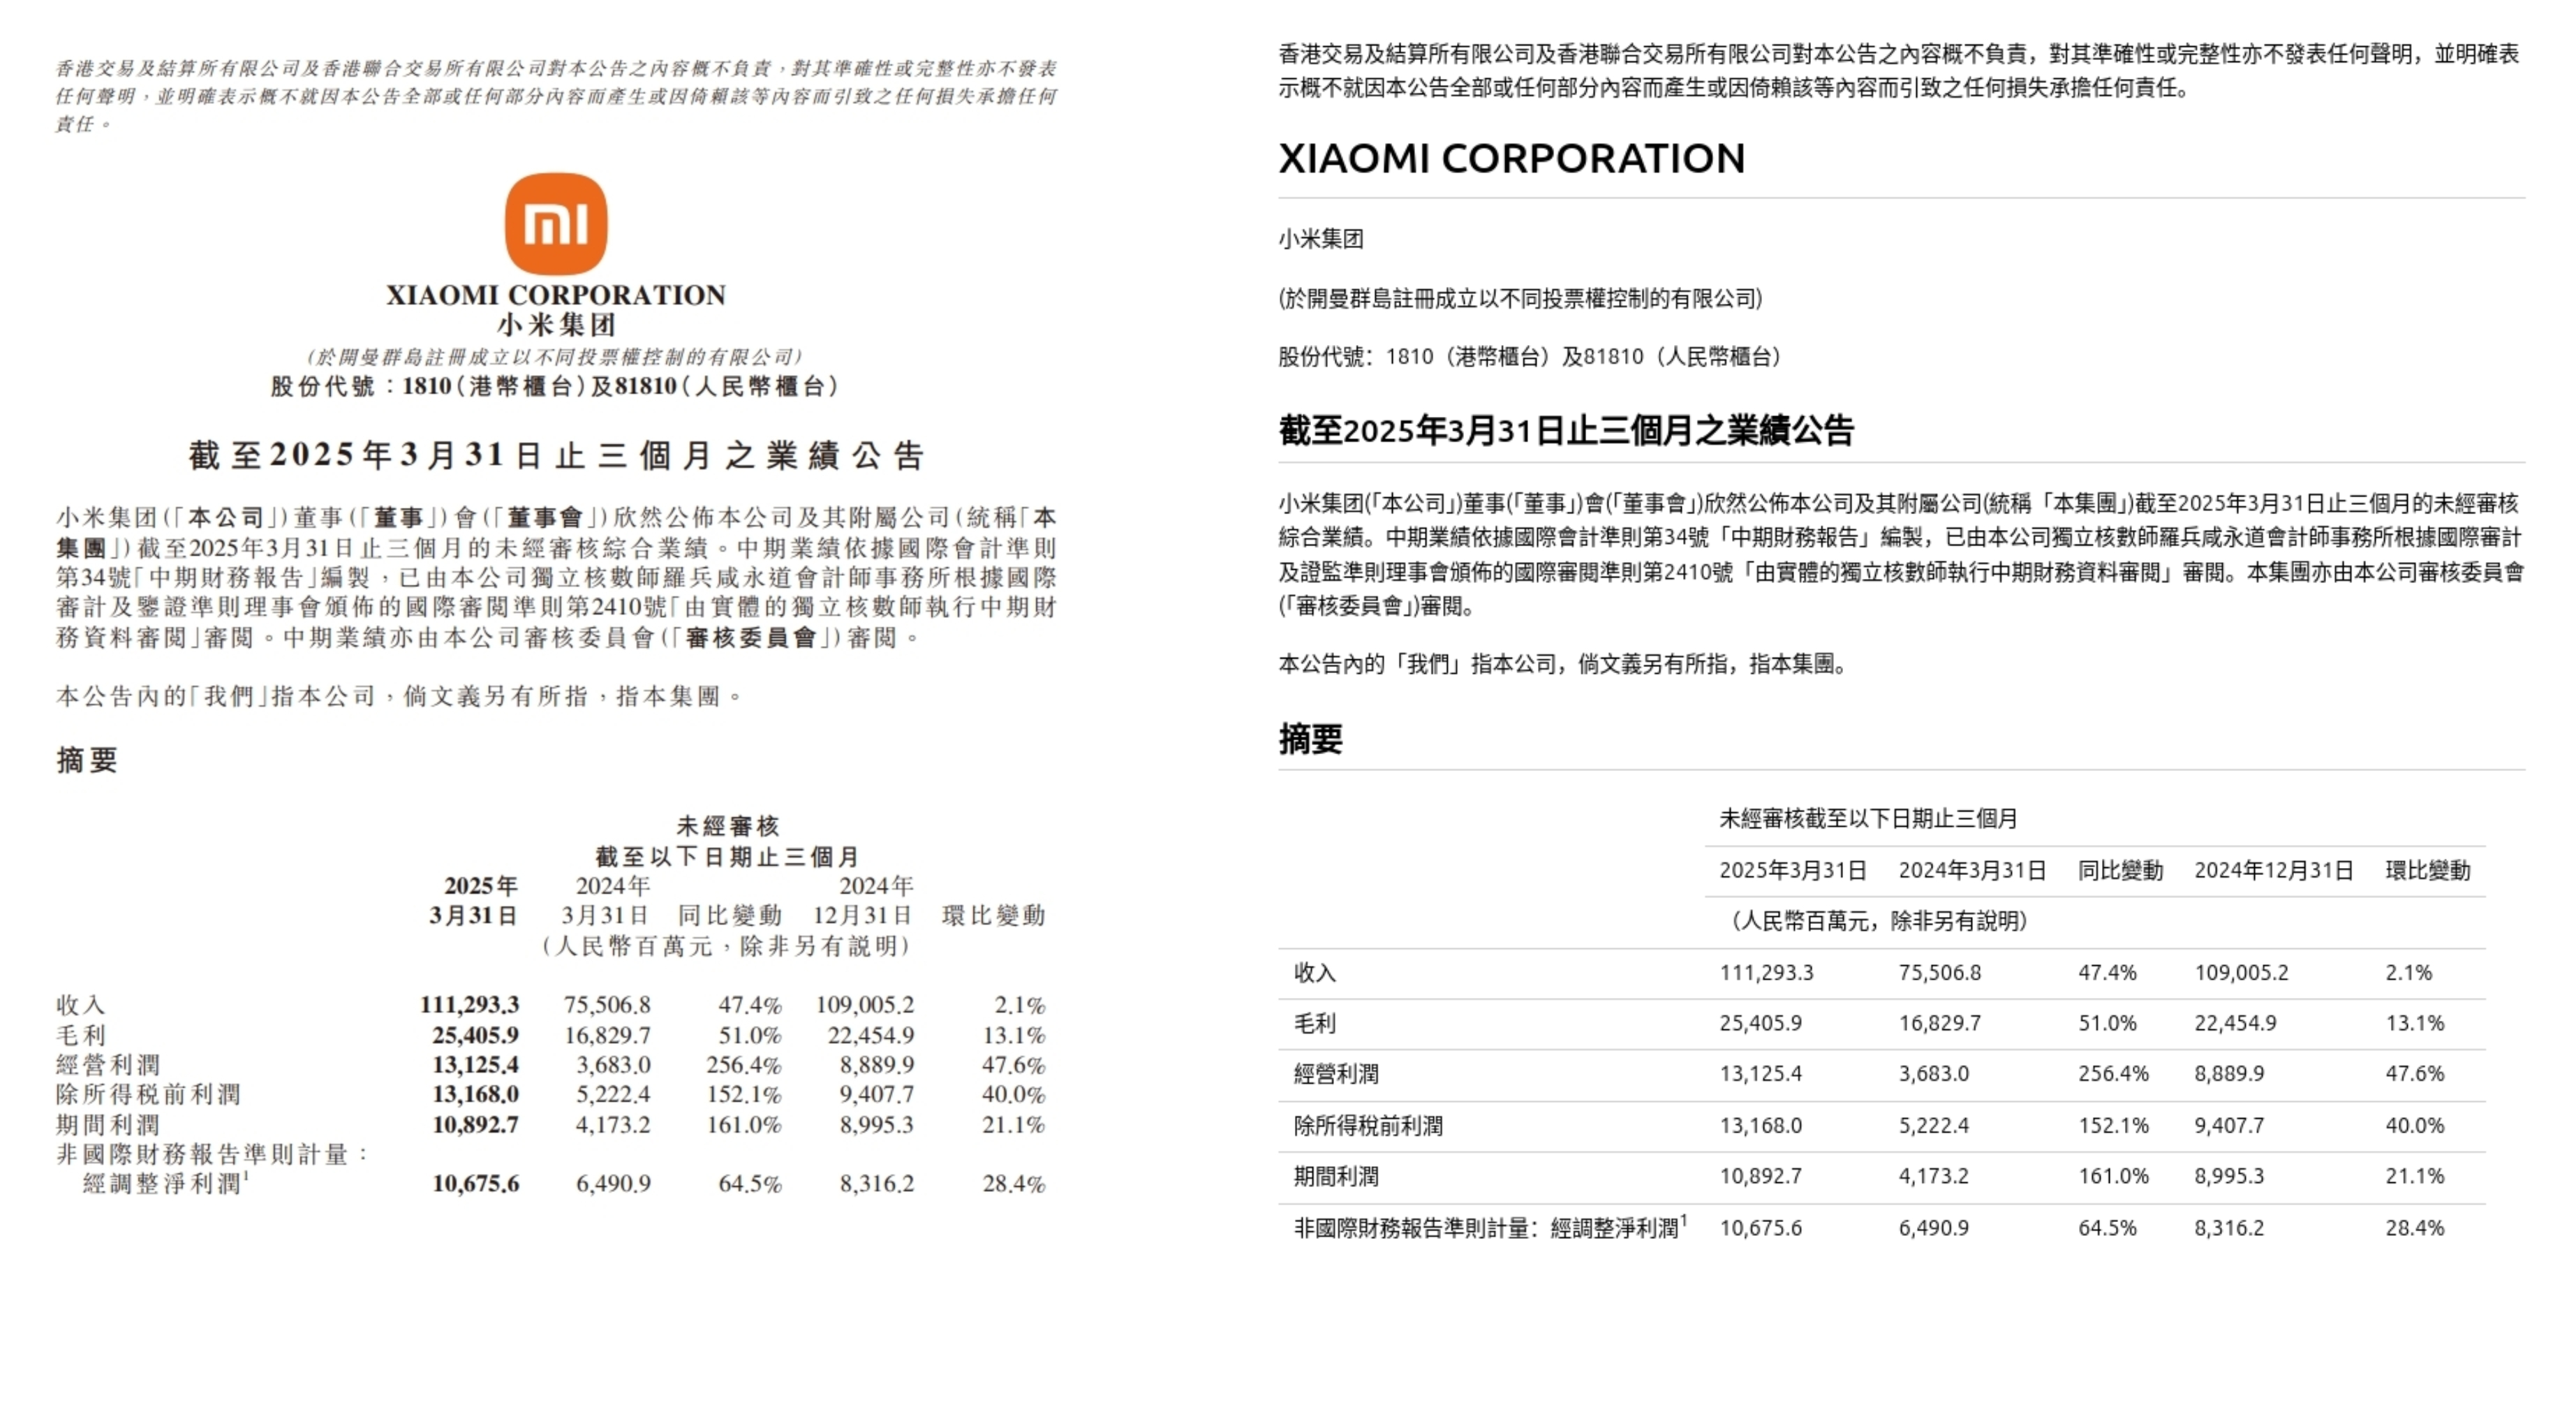 文档解析
04
高精度音频理解
在音频理解领域,我们自研热词语音识别、目标说话人识别等核心技术,打造高适配、高精度的智能音频理解体系,针对性解决专业词汇识别不准、多人语音重叠、高噪声干扰等实际场景难题。依托该能力,系统可在复杂环境下实现精准、个性化的语音交互,显著提升各类场景下的人机交互体验与识别准确率。
目标说话人识别
05
跨模态空间语义对齐
除此之外,我们结合万物定位核心技术,实现语言语义与视觉空间信息的精准对齐,打通"语义理解"到"目标定位"的全链路闭环。
该能力可为智能座舱、内容智能理解、智能交互等核心场景提供技术支撑,支撑设备完成精准的场景决策与智能执行,实现更贴合用户需求的全场景智能服务。
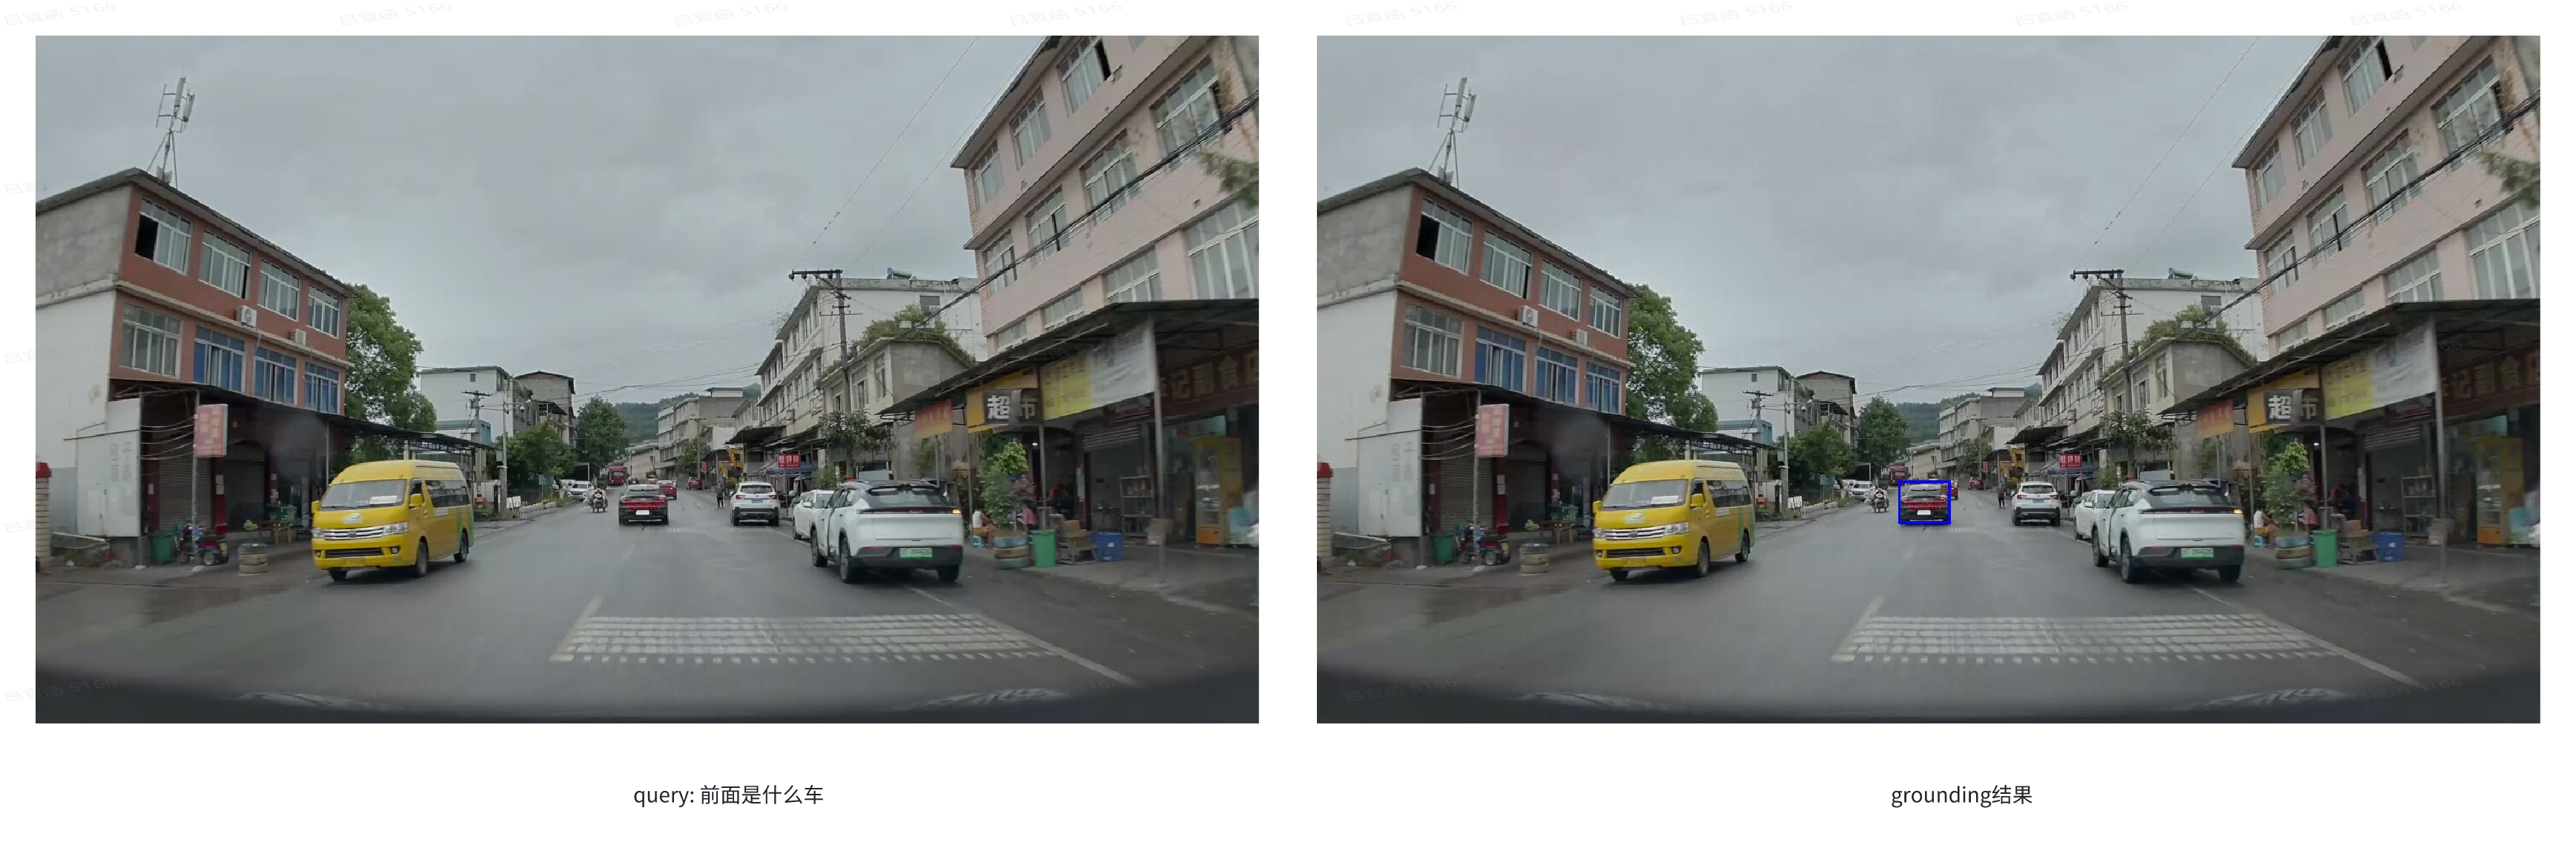 目标定位