多模态生成技术:从智能创作到可控落地的技术革新
2026-04-06
多模态生成技术的核心价值,是让模型不仅能够理解世界,还能够创造内容。通过统一的生成框架,系统支持图像生成、视频生成与图像编辑等多种生成能力,并实现文本、图像、深度、布局等多模态信息的联合控制,使生成过程从"随机生成"升级为"可控生成"。
01
图像生成:精细可控,适配业务落地
在图像生成领域,我们聚焦可控生成、个性化风格化创作、人像身份稳定还原、图像修复、高清画质增强等核心技术板块进行深度优化。在保障生成内容具备丰富创意表现力的同时,有效解决实际业务场景中画面不稳定、风格不统一、效果偏差等痛点,满足商业化落地的高标准要求。
- 图像风格化
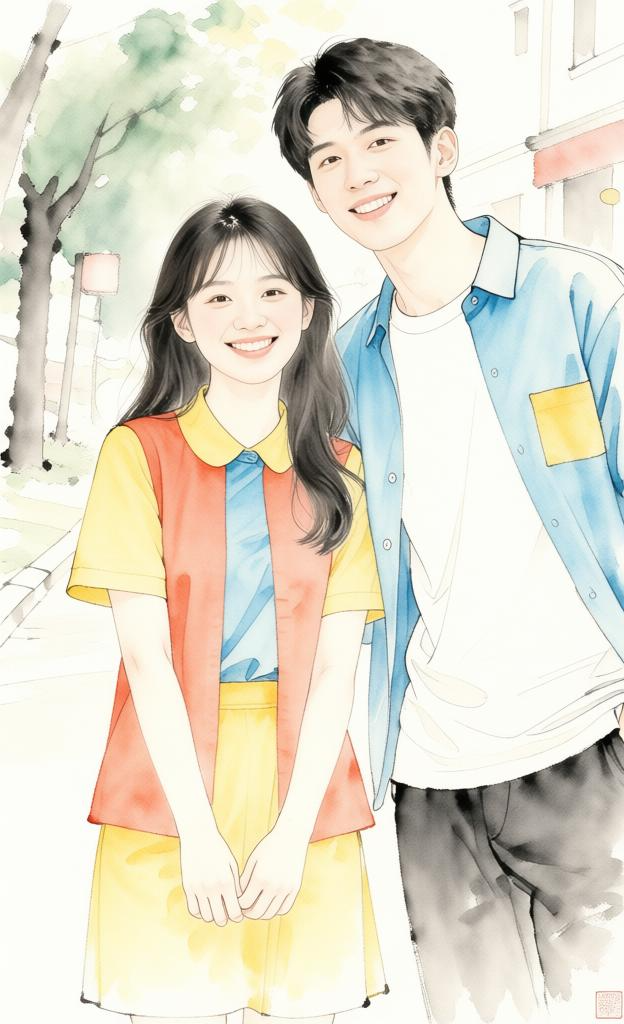 水彩
- 个性化生成
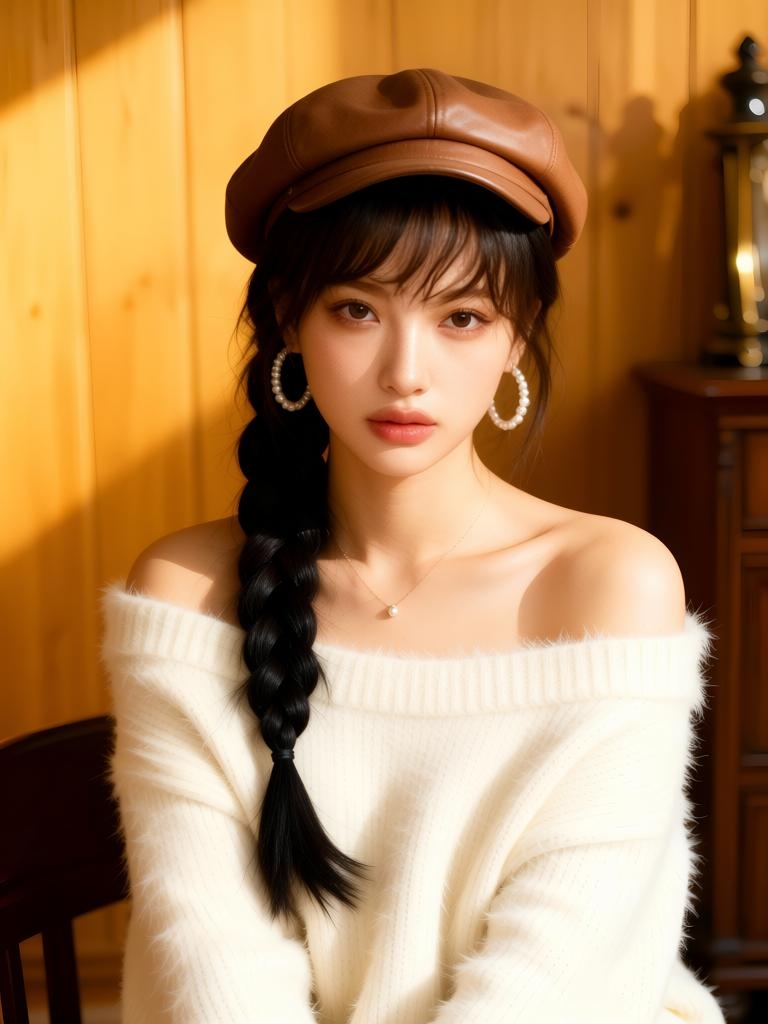 秋日写真
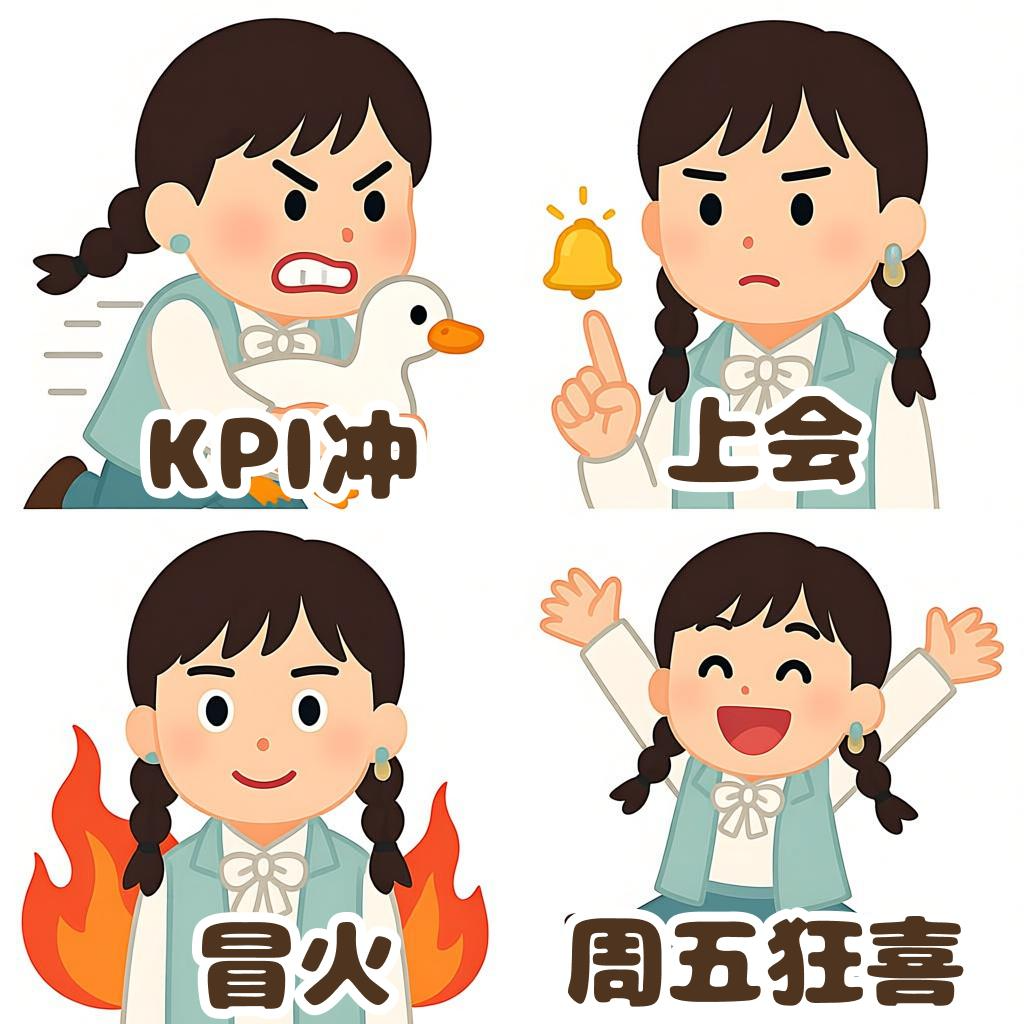 表情包
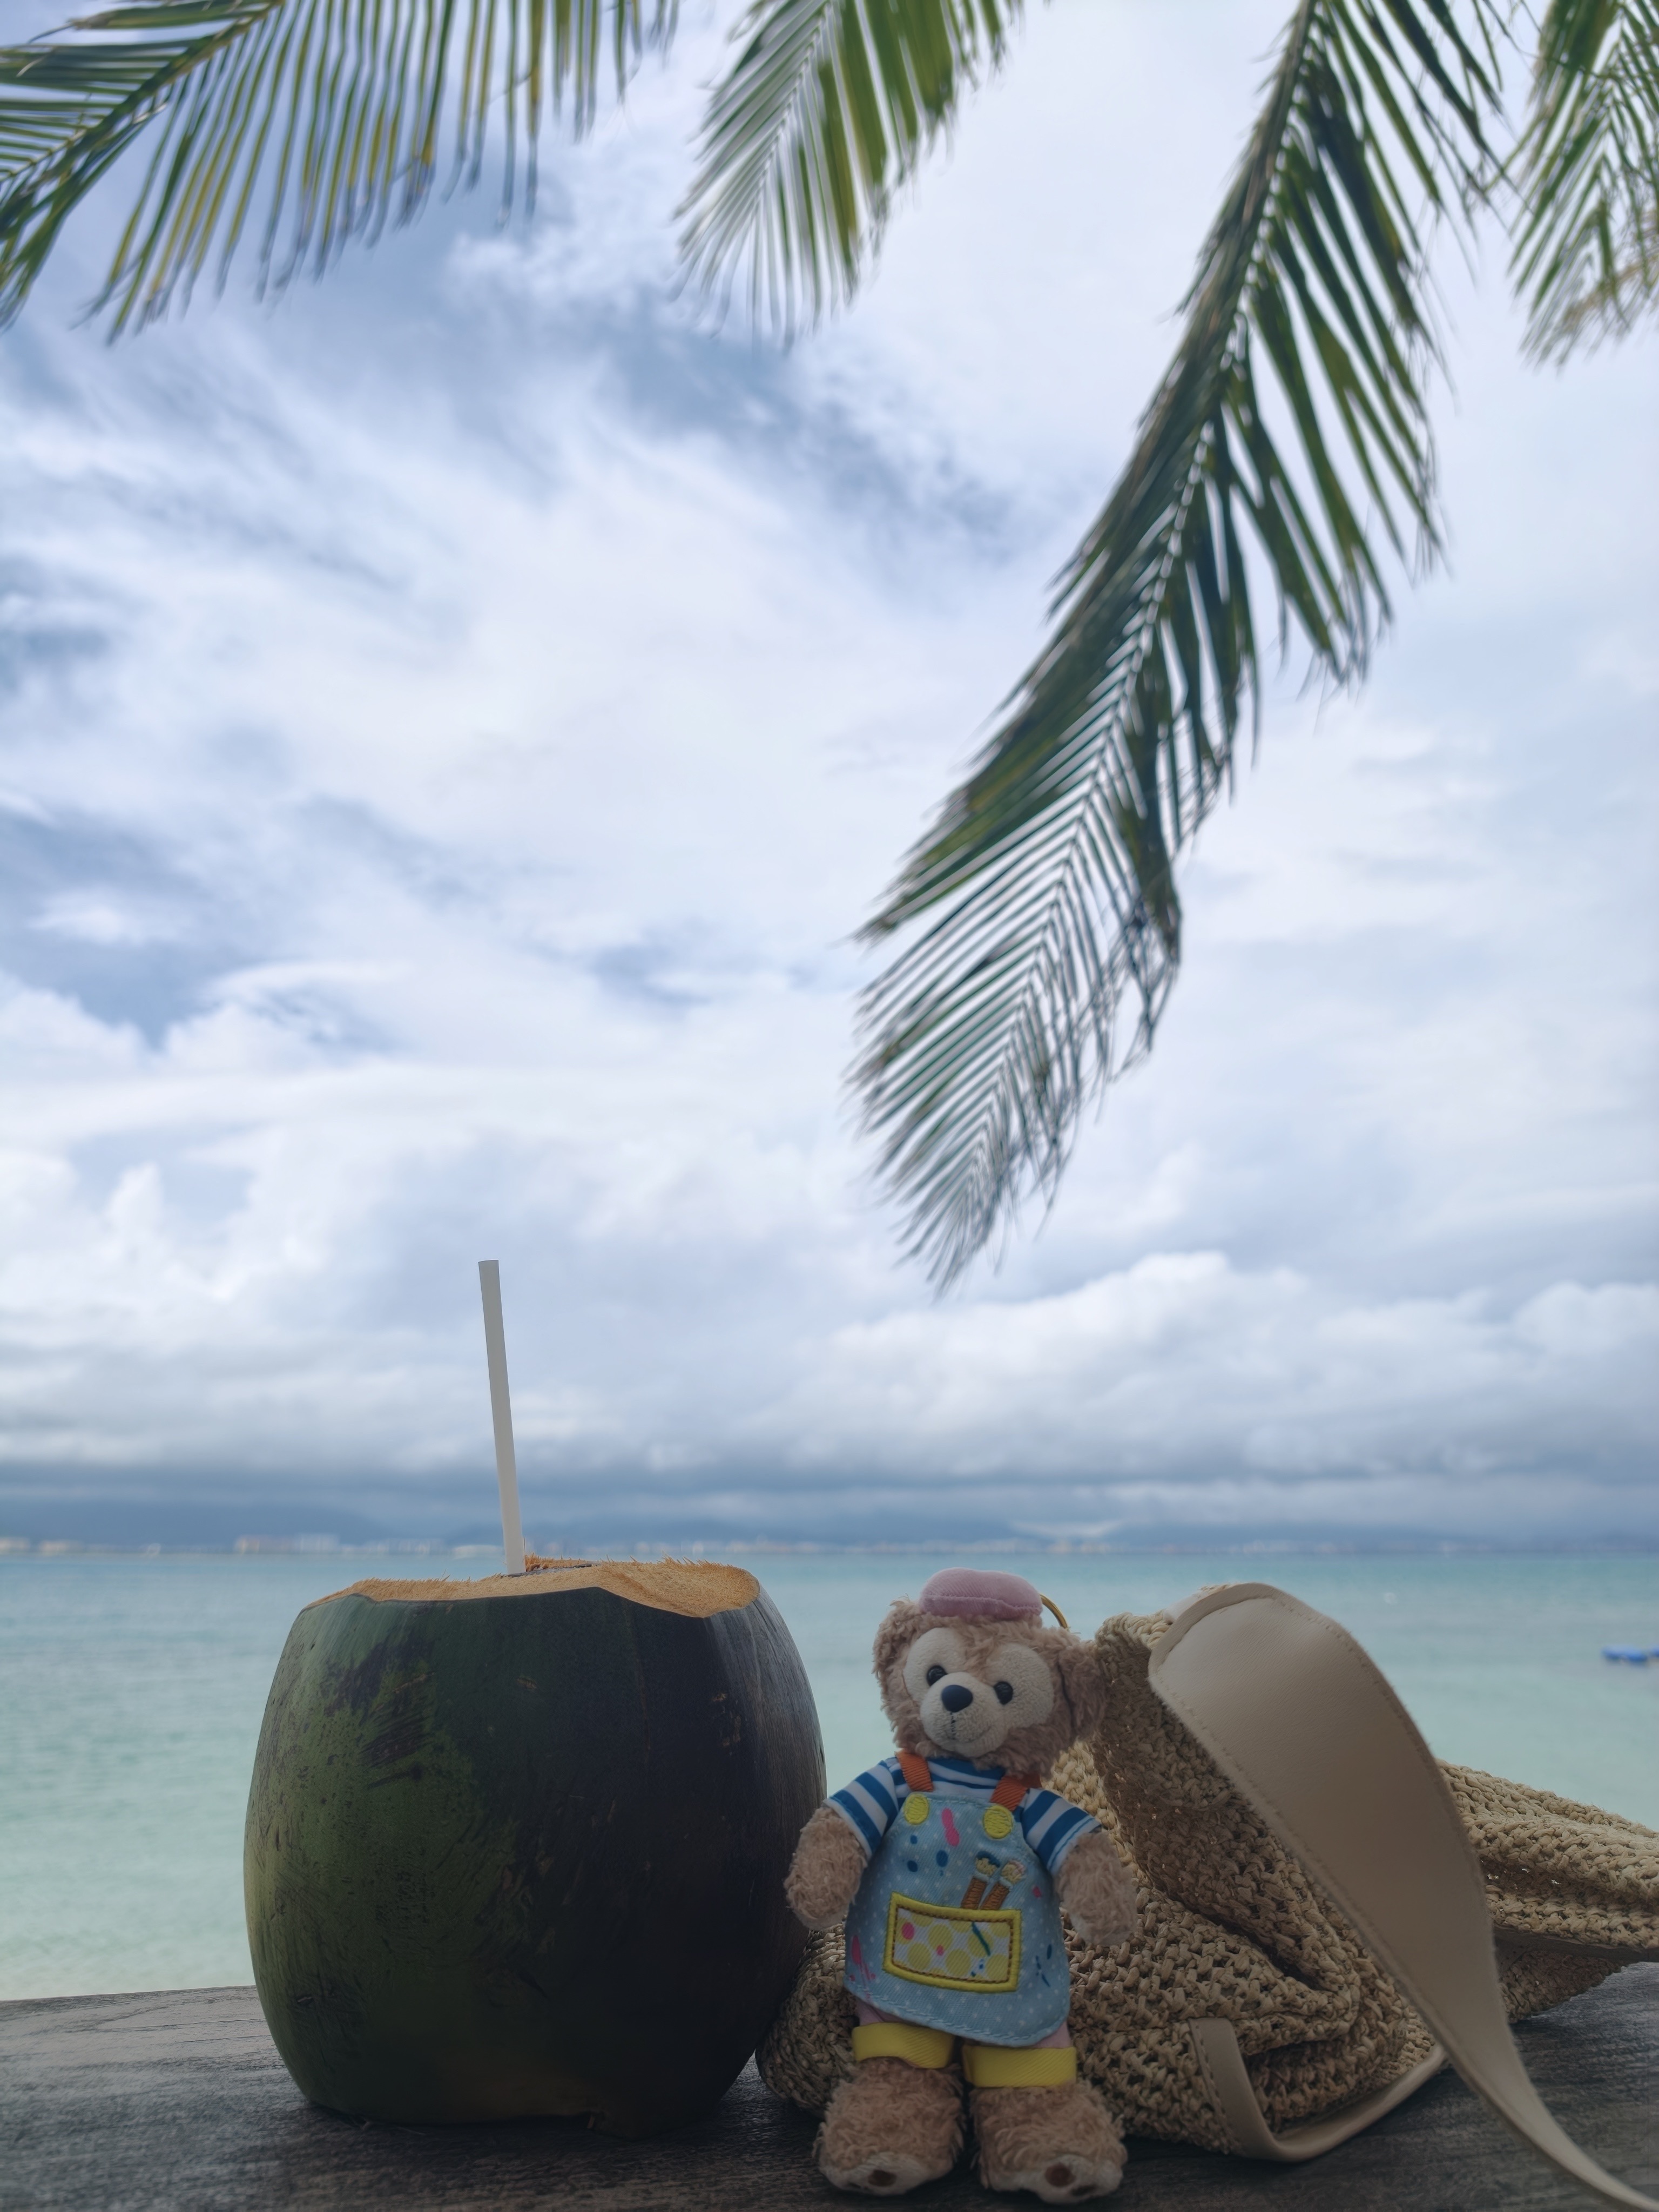
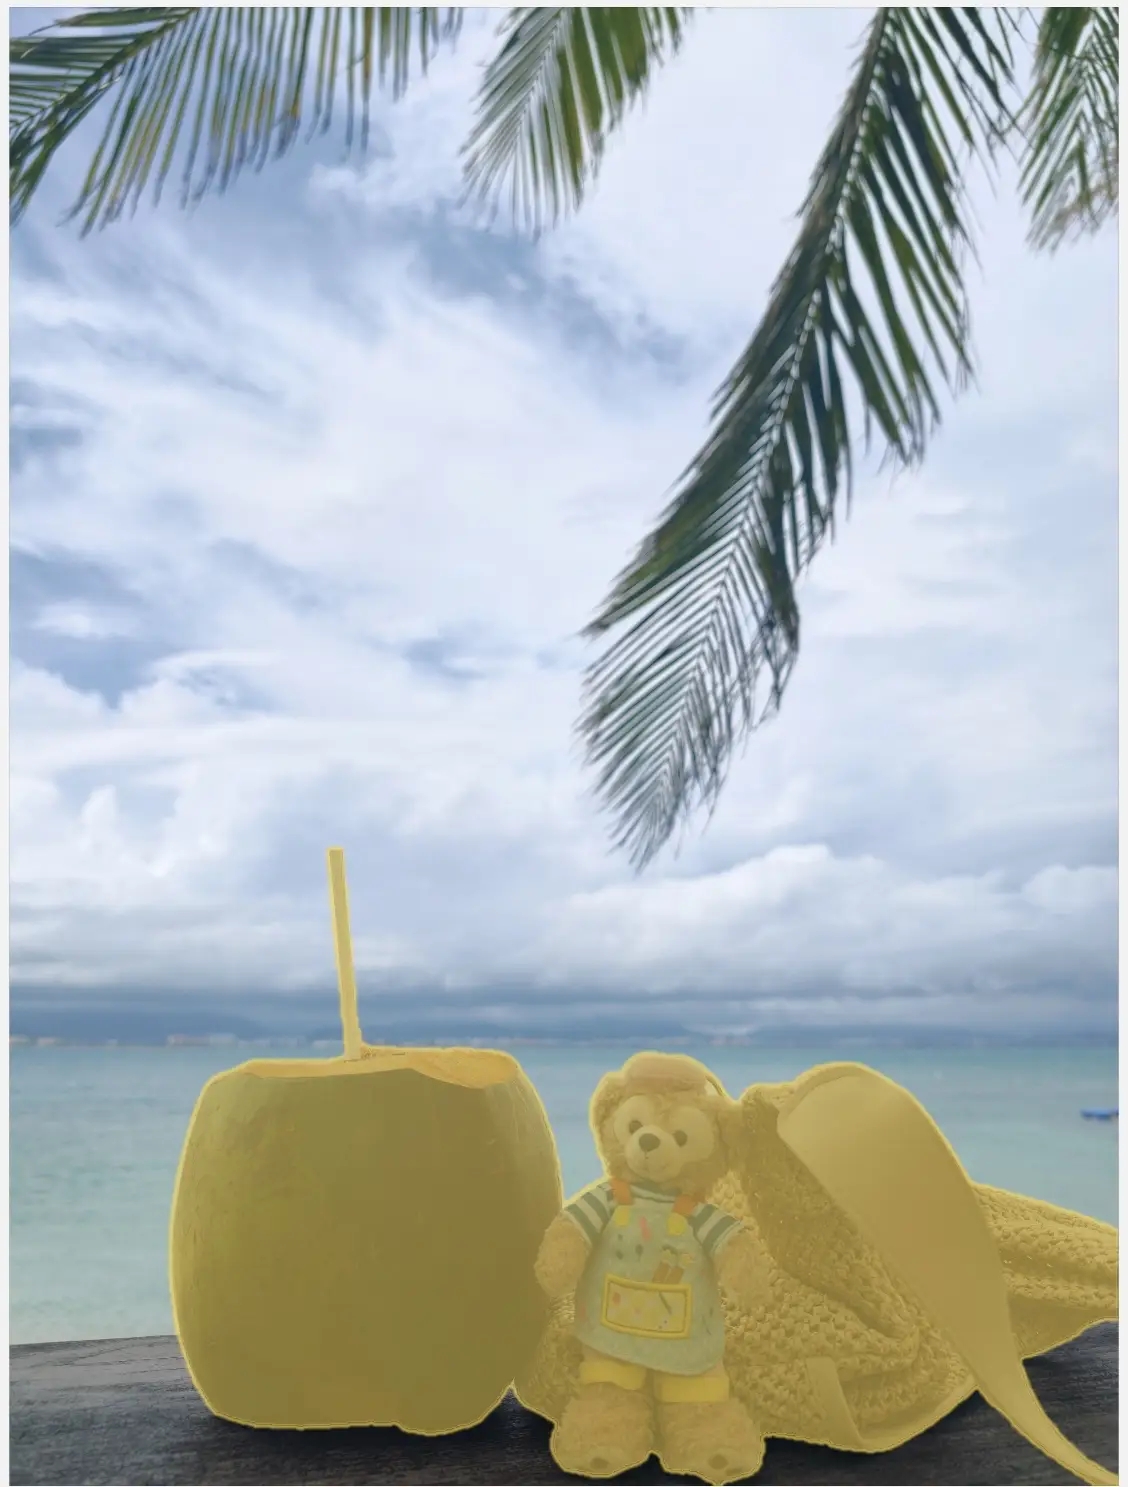
与此同时,依托高精度图像分割与交互式智能抠图技术,模型可实现像素级的画面空间感知与精准理解,为用户精细化图像编辑、自定义内容生成、精准效果调控等操作,筑牢底层技术基础,让图像创作更精准、更灵活。
- 画质修复
- 智能消除
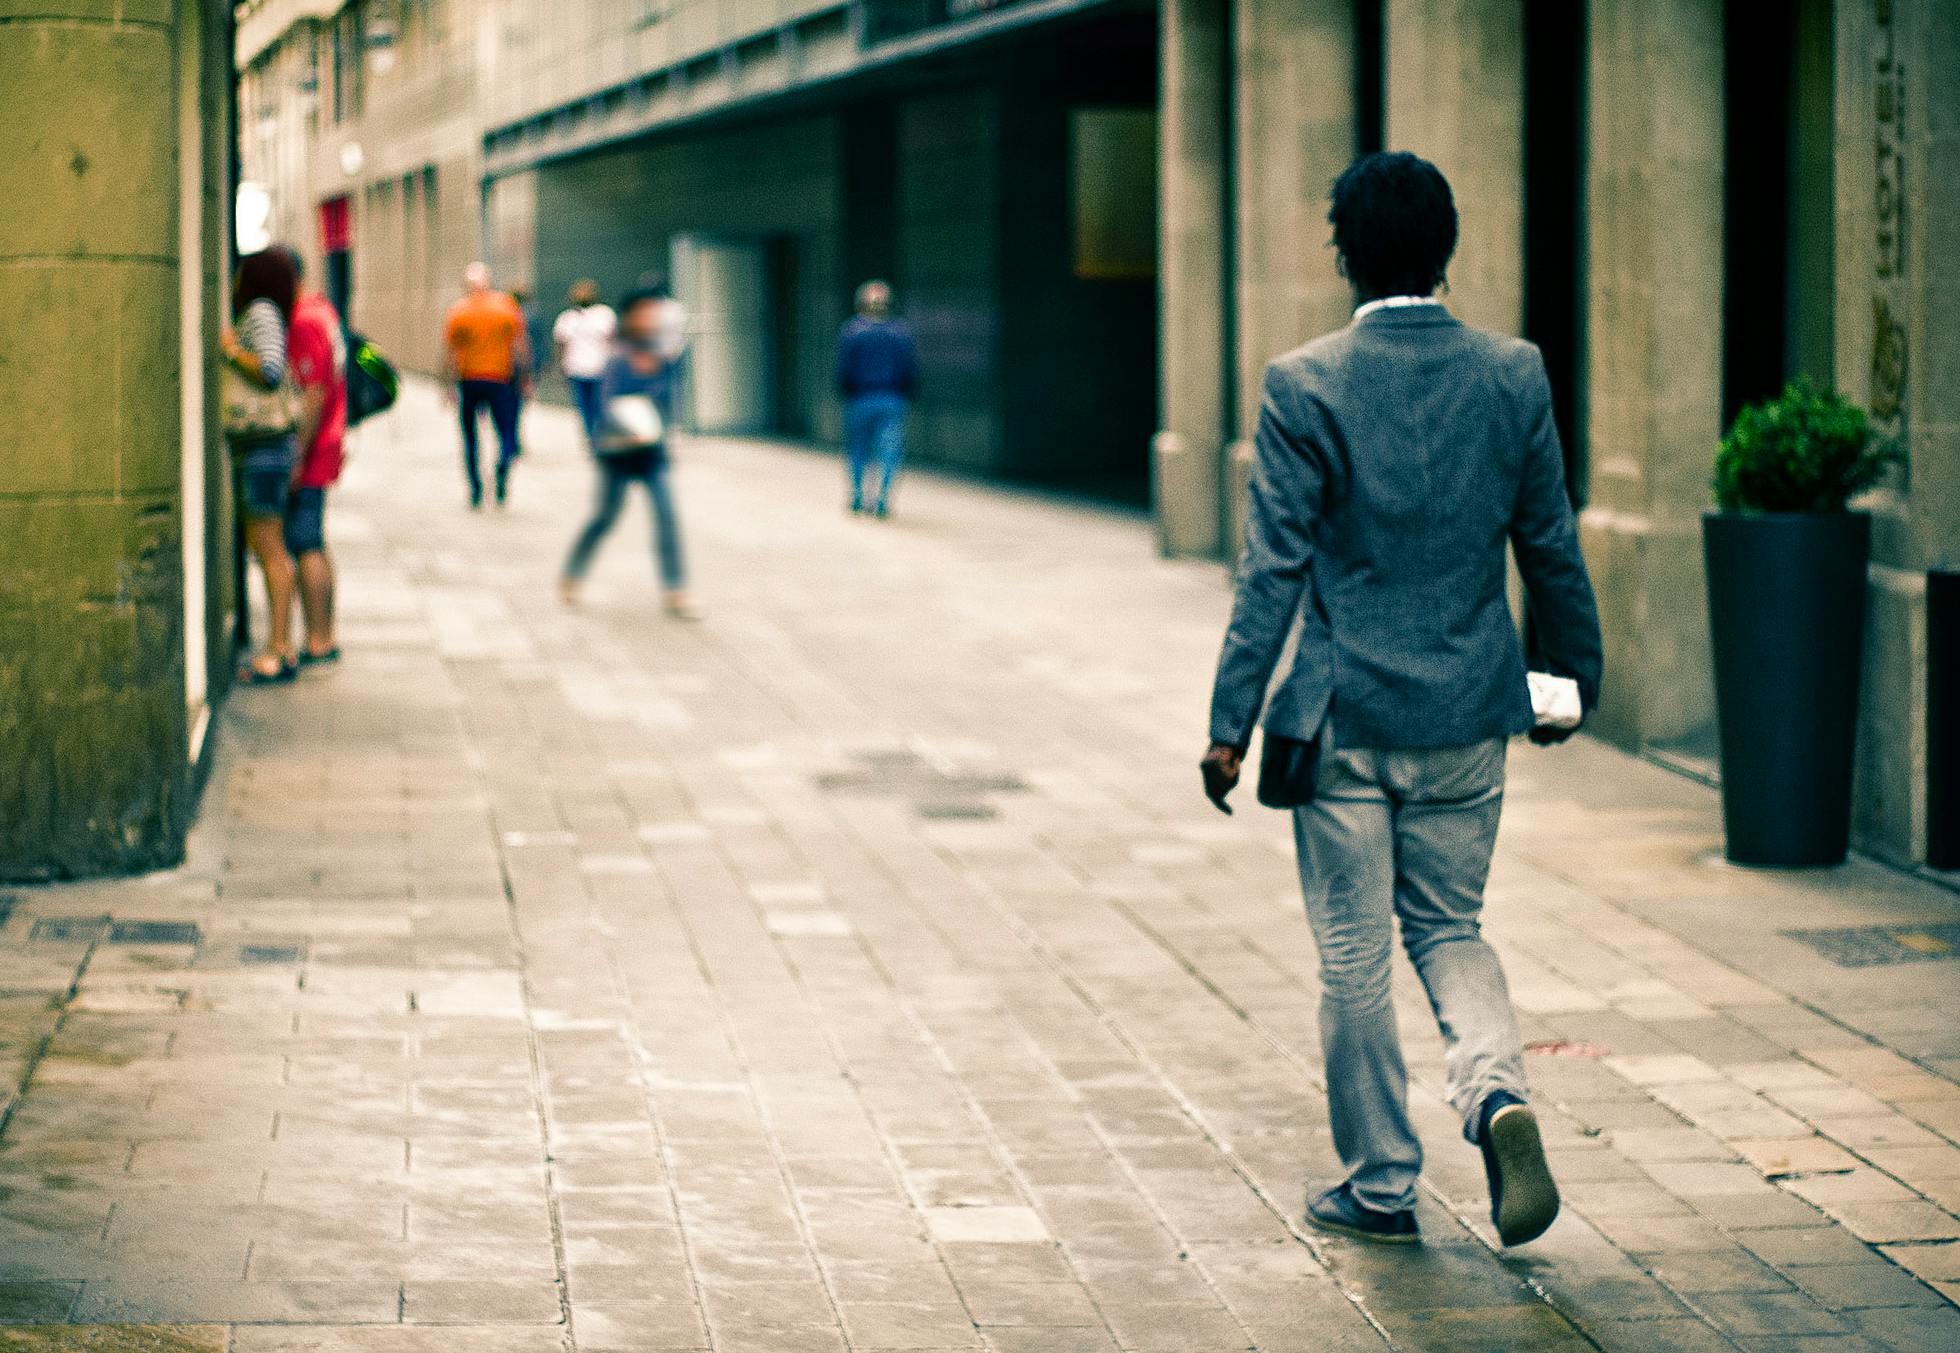
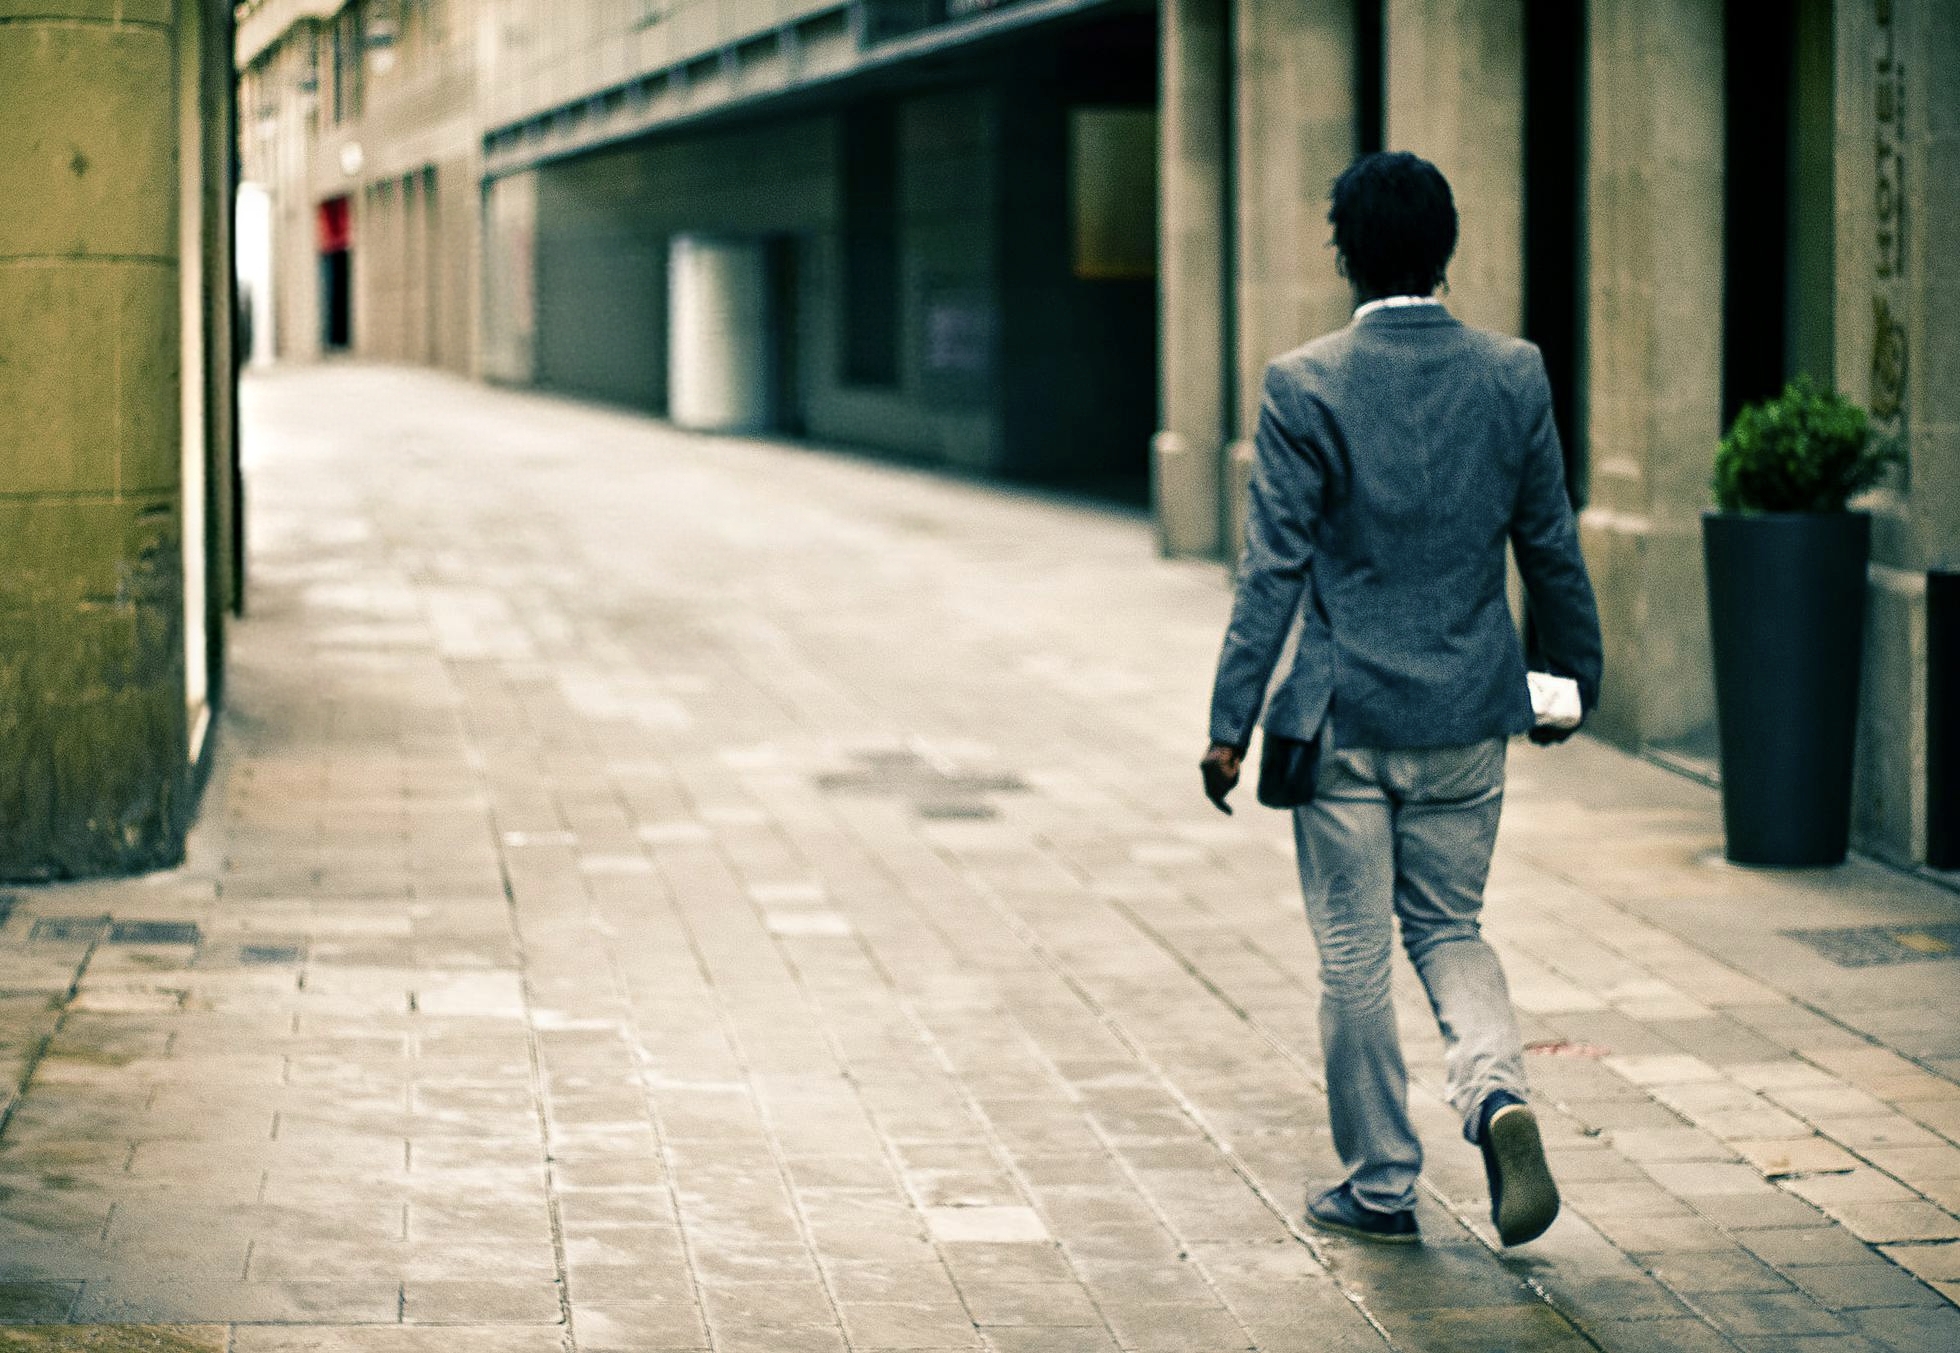
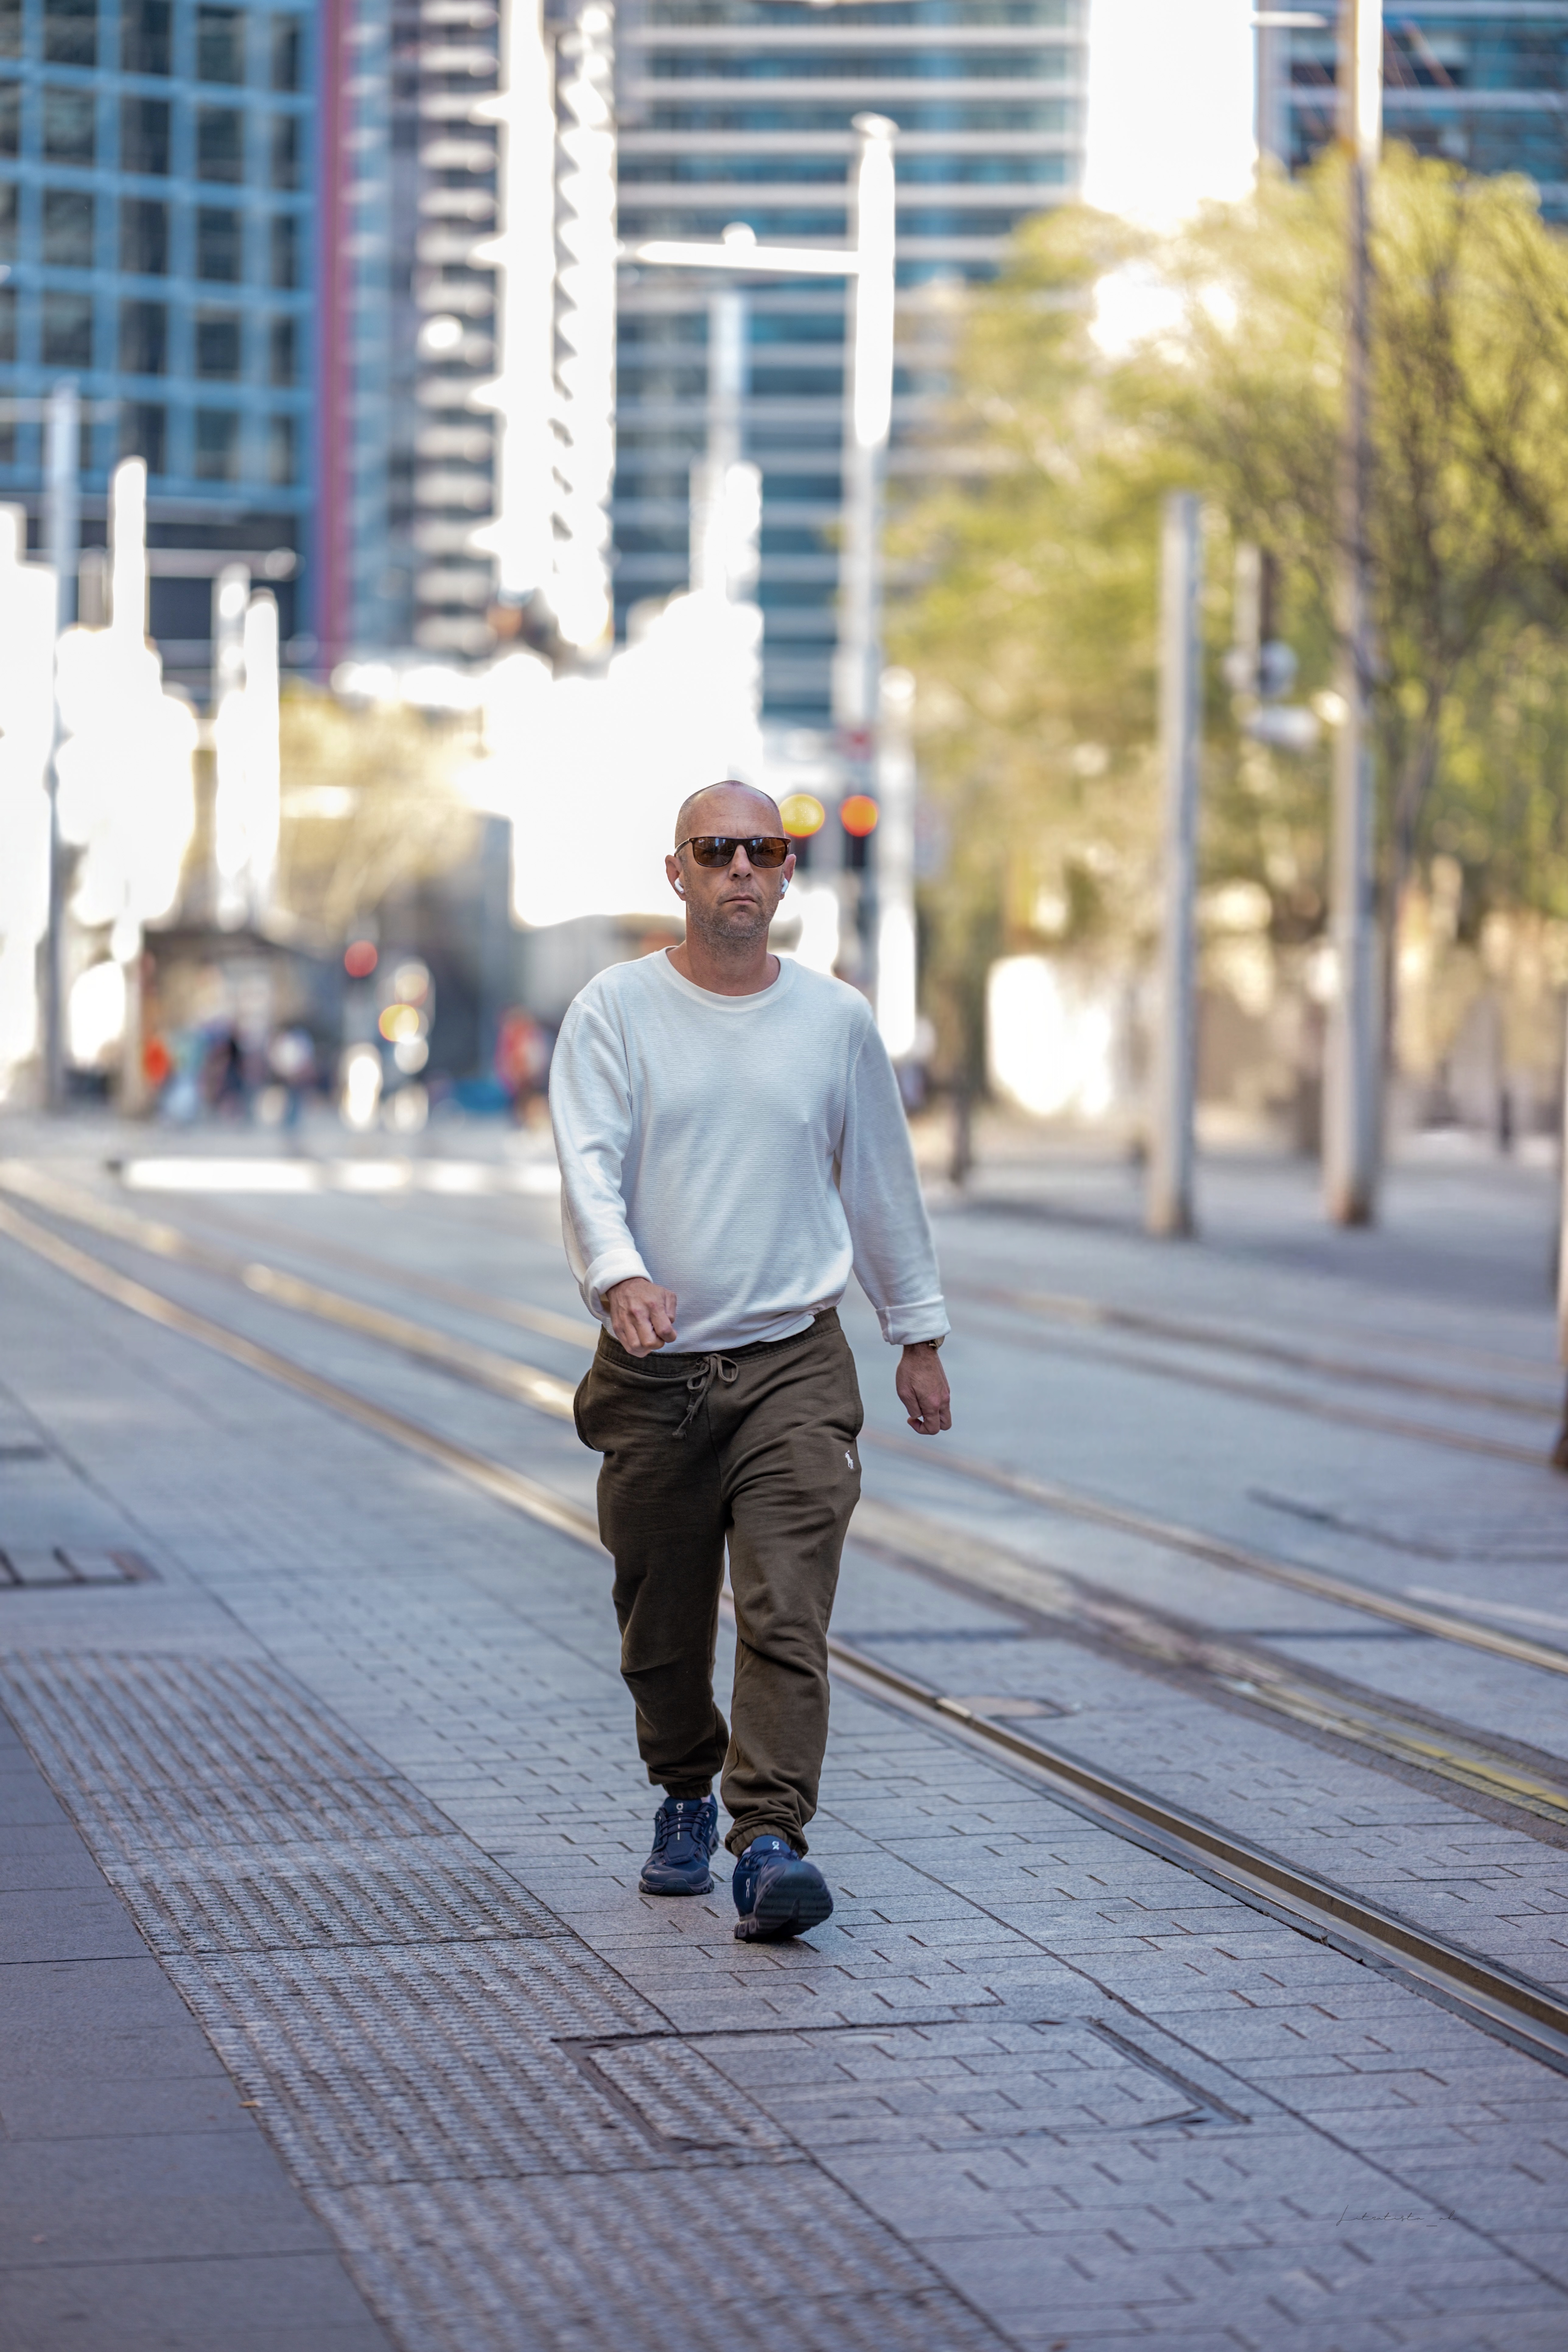
- 精细化分割抠图
02
视频生成:精准控效,高效落地场景
依托小米自研核心技术,我们在视频生成赛道聚焦可控动态生成与智能视频编辑两大核心方向,持续迭代核心技术体系。通过融入3D几何先验能力、实现画面主体与相机运动解耦控制、搭建多专家模型架构等创新技术方案,精准把控视频拍摄运动轨迹、主体动态变化、画面语义逻辑等核心要素。
该技术方案在高品质生成效果与高效推理速度之间实现了精准平衡,有效解决了传统视频生成画质模糊、动态失真、运算耗时久等问题,让高性能视频生成技术能够稳定适配手机、车载终端等各类终端设备场景,实现规模化落地应用。
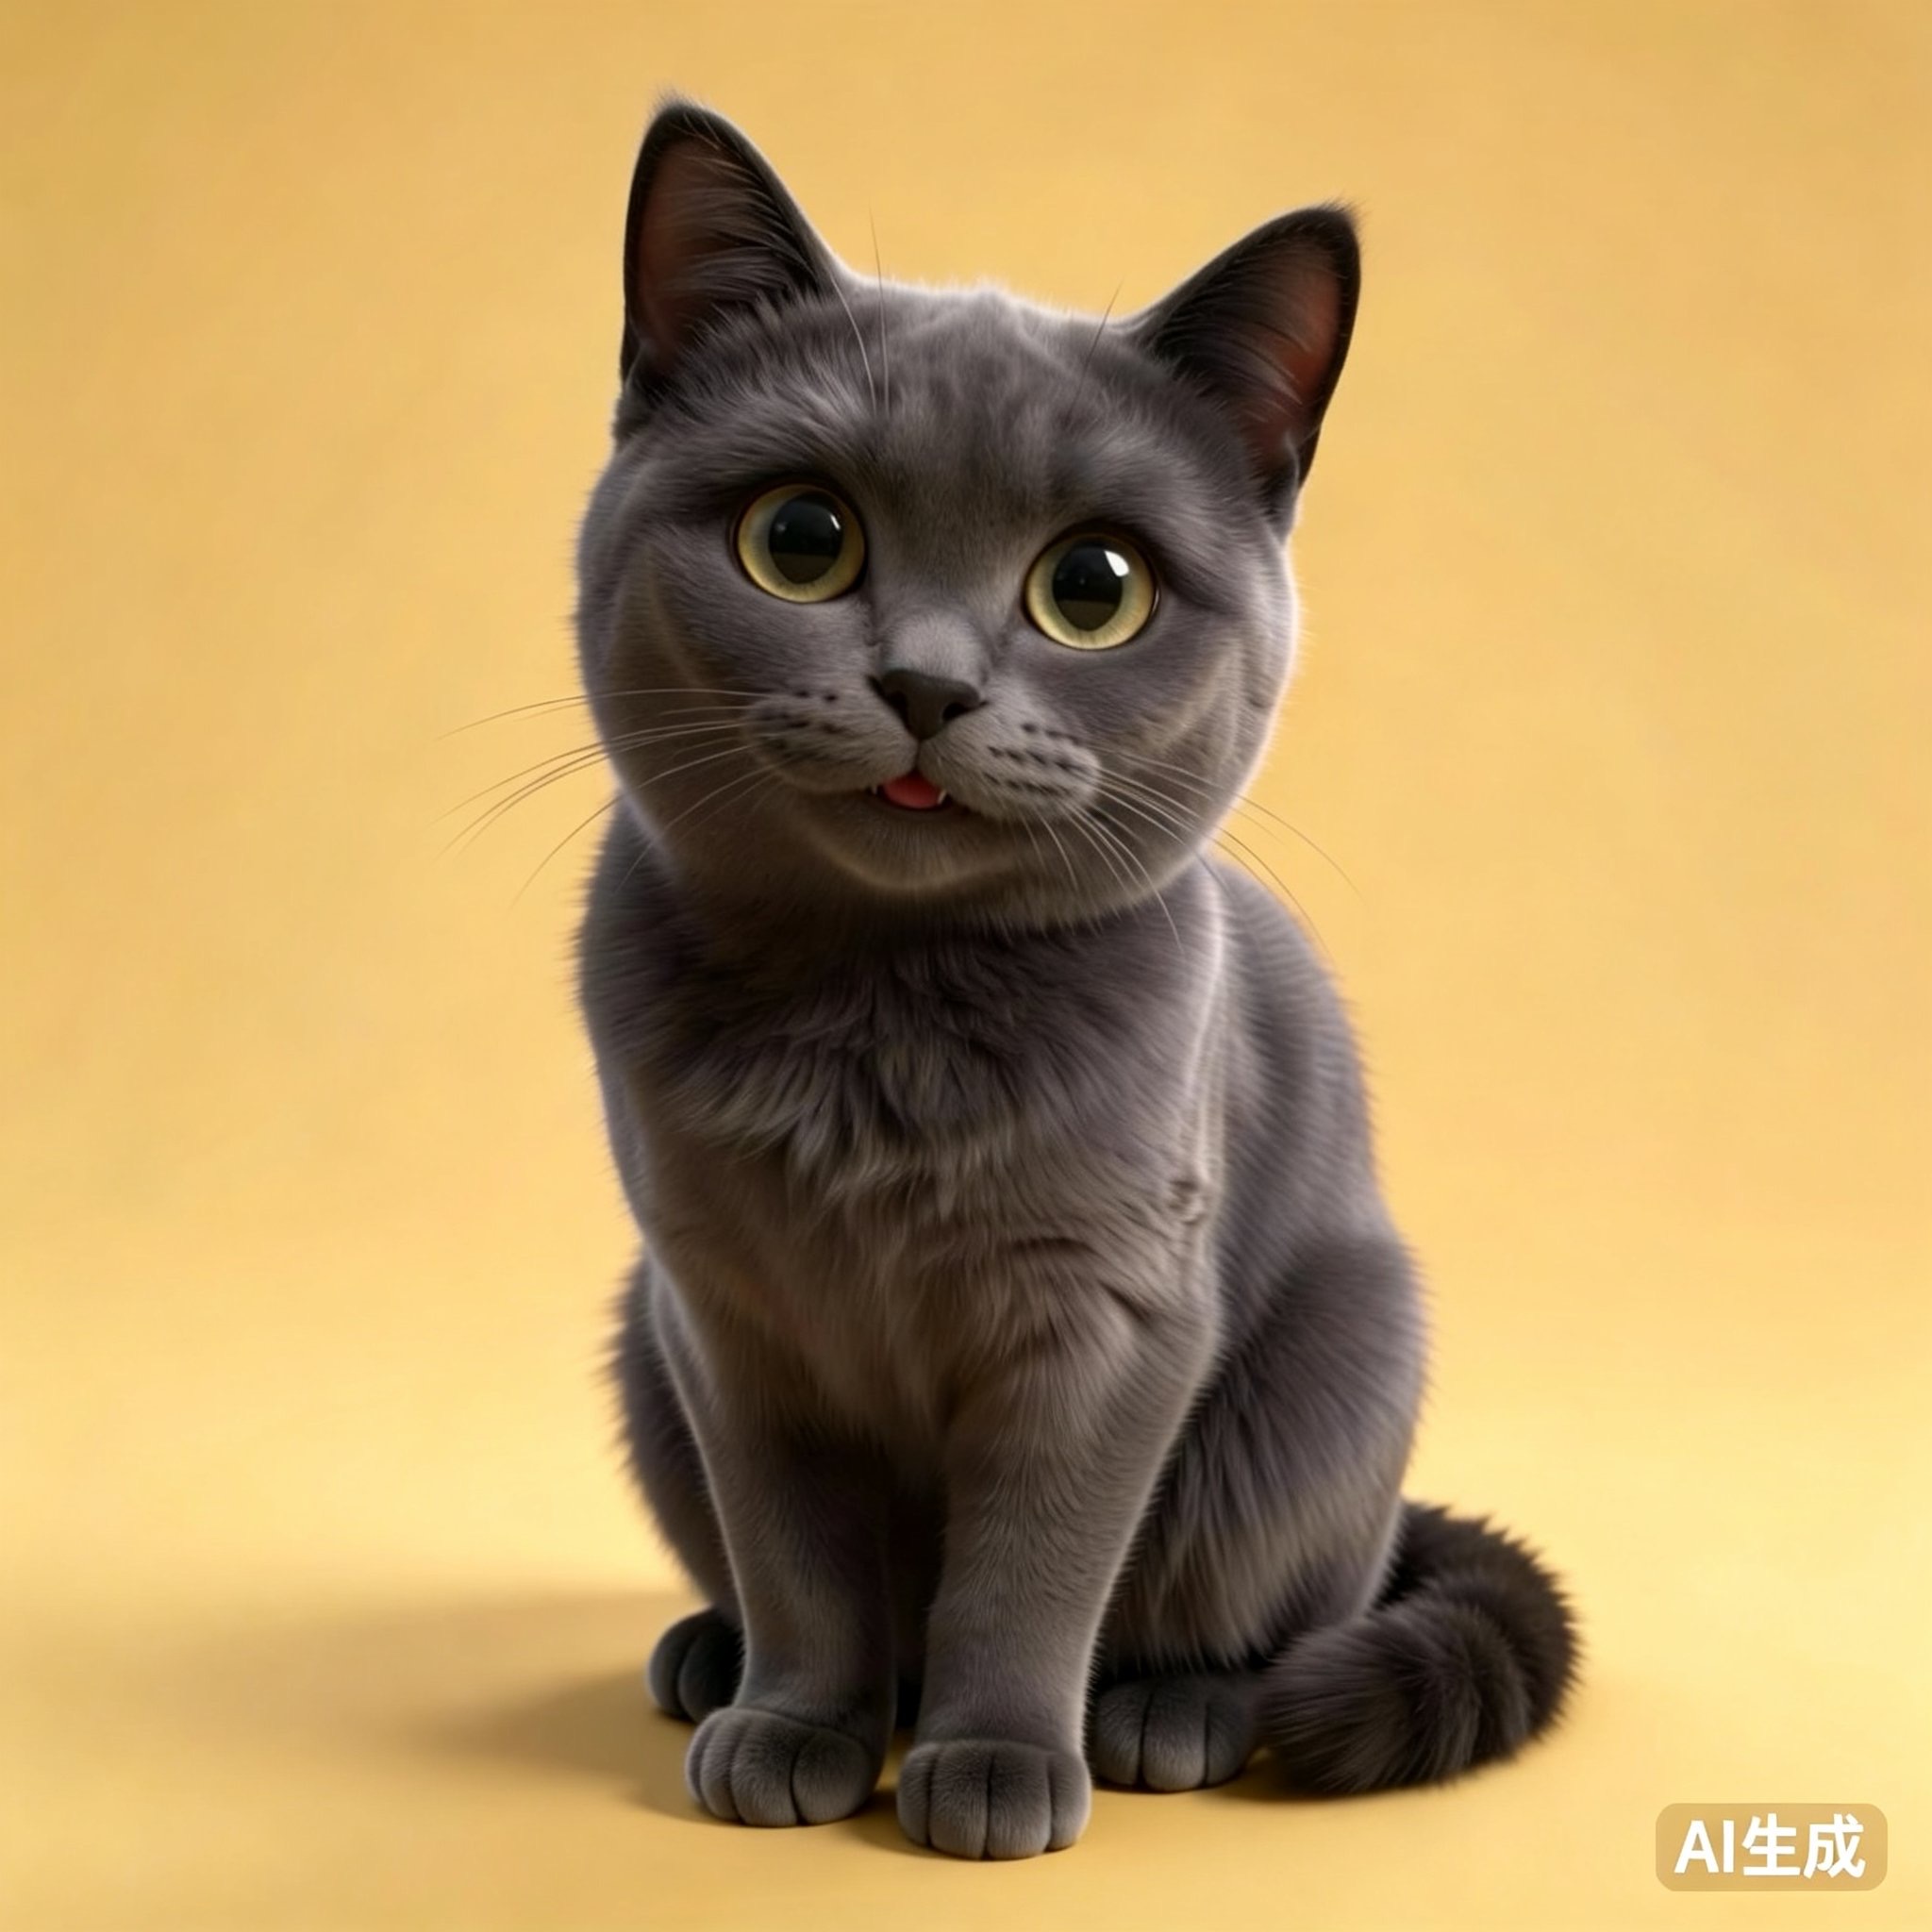
座舱萌宠
动态壁纸
图生子弹时间视频
视频物体/人物消除
视频反光消除
03
技术趋势:跨模态协同创作底座
纵观整体技术发展脉络,多模态生成技术正迎来全面升级迭代:从单一的图像、视频独立生成,逐步升级为跨模态协同生成;从粗放的整体内容生成,迭代为细粒度、精细化的精准控制。依托统一、完备的技术体系,整套多模态生成方案可在图像创作、视频制作、智能内容编辑等全场景中,持续输出高质量、可精准调控、可商业化落地的智能生成能力,成为AI内容创作、人机智能交互领域的核心底层技术支撑。