小米 AutoResearch:重塑 AI 时代算法研发全新范式
2026-04-06
在人车家全生态高速发展的背景下,AI 算法已成为小米智能座舱、智能驾驶、智能家居、能耗优化等核心业务的核心驱动力。传统算法研发模式存在调研低效、知识割裂、实验重复、部署脱节等诸多痛点,严重制约研发迭代速度与创新效率。为此,小米重磅打造 AutoResearch AI-Native 研发新范式,构建新一代 AI 算法研究中台,以多智能体协同架构打通算法研发全链路,实现人效 10 倍以上提升,铸就小米在工业 AI 算法研发领域的差异化核心竞争力。
01
传统算法研发核心痛点
长期以来,工业 AI 算法研发依赖人工全流程参与,流程碎片化、经验难沉淀、迭代成本高,主要表现为以下五大核心瓶颈:
调研效率低下:人工查阅论文、复现实验流程繁琐,单篇论文调研+代码复现平均耗时高达 7 人天。
知识无法沉淀复用:各项目独立搭建知识库,团队成功经验、失败教训难以跨项目共享,项目越多信息冗余与过载越严重。
需求迭代适配困难:业务需求频繁变动,导致实验特征、数据切分反复调整,前后实验结果失去可比性,过往结论频繁失效需重新验证。
重复劳动占比过高:训练发散、实验失败等无效结果无标准化记录,研发人员极易重复踩坑,30%-50% 的研发工时耗费在无效重复工作中。
部署链路存在断层:从模型训练到 ONNX 转换、TensorRT/QNN 部署全程手工操作,算子改写、量化对齐等流程繁琐,单次部署耗时 3-5 天。
02
打造四大核心适配建模场景
AutoResearch 秉持 建模范式中立 设计理念,精准适配工业 AI 四大主流建模场景,针对性破解各场景技术难题:
纯数据驱动 AI 建模:解决人工调参低效、特征工程依赖经验、模型选型缺乏横向对比等问题。通过多 Agent 并行赛马自动搜索超参,搭建特征工程模板库实现经验沉淀,对每一次模型改动进行严格归因判定,精准保留有效优化、剔除无效尝试。
数据与机理融合 AI 建模:攻克物理机理与数据规律融合难、多物理域耦合复杂、陌生工况精度退化等痛点。将物理机理损失项纳入核心优化维度,智能平衡数据损失与物理约束权重,实现数据规律与行业机理的深度融合。
小数据场景 AI 建模:针对研发场景数据量不足、模型易过拟合、结构化大模型训练数据稀缺等问题。依托 DAG 有向无环图、仿真系统自动合成增量数据,以未见工况作为隔离测试集,全方位验证模型泛化能力。
智能决策场景 AI 建模:适配自动驾驶、底盘控制等容错率低的决策场景,平衡探索与利用的博弈关系,规避数据分布漂移影响。采用离线强化学习搭配安全约束训练,关键决策引入人在回路(HITL)交互机制,保障决策安全可靠。
03
全链路系统架构与智能体分工
小米 AutoResearch 搭建 Orchestrator 全局调度中枢,重构研发分工模式:研发人员仅需聚焦需求定义、约束设定、评估标准制定三大核心工作,通过 requirement.yaml、约束文档、评估逻辑文档即可发起研发任务,调研、编码、训练、迭代、部署等重复性"脚手架"工作全由 AI 智能体承接。平台搭载六大核心智能体,形成闭环协同研发流水线:
- 论文调研 Agent:跨外部文献、内部知识库、历史实验经验多维检索,并行筛选论文专利,提炼创新研发思路。
- 算法设计 Agent:将研究思路快速转化为可执行代码,多方案并行实现赛马,维护可复用算法模板库,覆盖损失函数、模型蒸馏、数据过滤等多元技术路径。
- 实验执行 Agent:自动完成仿真数据合成、多线程模型训练、硬件资源调度,合理分配 GPU 与实验台架资源,提升资源利用率。
- 评测分析 Agent:开展多维模型评估与 k-fold 交叉验证,严格隔离测试集杜绝数据泄露,自动生成实验图表、分析报告与复盘文档。
- 落地交付 Agent:实现模型跨平台一键导出,支持 ONNX、TFLite、QNN 等格式适配,自动完成量化校准与精度对齐,打通量产上车、线上部署、论文发表全通道。
- 监控沉淀 Agent:实时监测需求变更并分级触发迭代,项目结束后自动将成败经验沉淀至全局知识库,实现知识永久复用、正向赋能后续项目。
同时,平台内置七状态机闭环调度机制,贯穿初始启动、研究调研、算法设计、实验执行、评测评估、部署上线、监控迭代全流程,按变更等级自动触发小幅调整、重大重构或全新研发,保障研发流程标准化、智能化。
_20260914175403A075.png)
04
行业前沿对比:打造工业级完整研发生产线
当前全球 AutoResearch 相关技术各有侧重,按照工程复杂度顺序,我们分别调研了 Karpathy 的 AutoResearch(单 Agent loop)→ Anthropic AAR(并行 Agent 沙箱)→ AI Scientist v1/v2(多角色流水线 Scientist)。
Karpathy AutoResearch:聚焦单 Agent 极简迭代,仅实现单一实验循环调参,无论文调研、无部署/评估/报告环节,不支持物理先验,仅适用于轻量化个人实验。
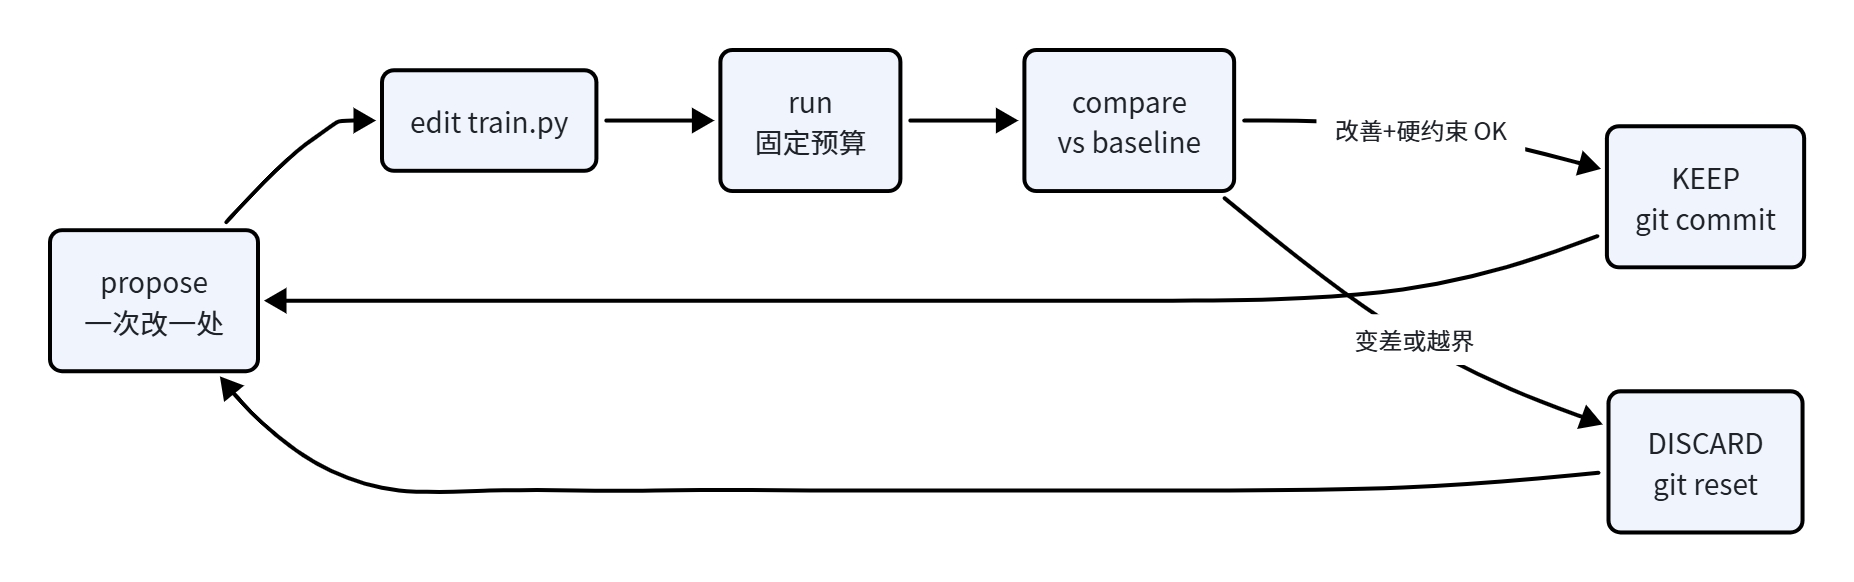 AutoResearch(Karpathy)架构
Anthropic AAR:Anthropic 2026 年 4 月公开的实验——让 9 个 Claude Opus 同时在独立沙箱里研究同一个开放问题,5天自动达到的精度(PGR=0.97)超过 2 位人类专家 7 天调优的最好成绩(PGR=0.23),总成本约 1.8 万美元(≈每 Agent 小时 22 美元)。
PGR(Performance Gap Recovery,性能差距恢复率):0 表示模型相对弱基线没改善,1 表示已达到"用真实标签直接训"的上限。关于Anthropic AAR,有四个重要发现:
1.必须强制多样性:给 9 个 Agent 分配 9 个不同研究方向(如自训练、集成、蒸馏、数据过滤、置信度加权等),精度提升远快于"同一个提示词跑 9 遍"。否则所有 Agent 会自发收敛到一两条"看起来对"的路线。
2.给"模糊方向"比给"具体步骤"更好:预先列几十个具体想法反而效果更差——在实验过程中根据 loss 曲线动态生成的方案更有效。给一个大致探索方向即可。
3.不要写死流水线:让 Agent 自己决定先跑廉价小实验还是直接全量训练,比规定"先 propose → 再 plan → 再 run"效果更好。Agent 在自由编排下更像专家研究者。
4.Agent 会找评估漏洞:只要评估指标可被多次提交,Agent 就会发现各种捷径——挑随机种子刷分、反推测试标签、绕过模型直接跑单测拿真值。对工业部署的启示:测试集必须严格隔离,否则数据驱动 Agent 会"刷分"而不是真的解决问题。
_20260914175425A076.png) Anthropic AAR架构
AI Scientist v2:让 LLM 完成"想 idea → 设计实验 → 跑代码 → 写 LaTeX → 自动评审"全流程,产物是可投稿的论文。v2 在 v1 基础上在 Experiment 阶段引入 agentic tree search,把实验过程组织成树搜索,每个分支独立跑实验、赢家回填父节点;加入 VLM 视觉反馈,让多模态模型自动检查生成的图表,纠正坐标轴 / 标注错误。
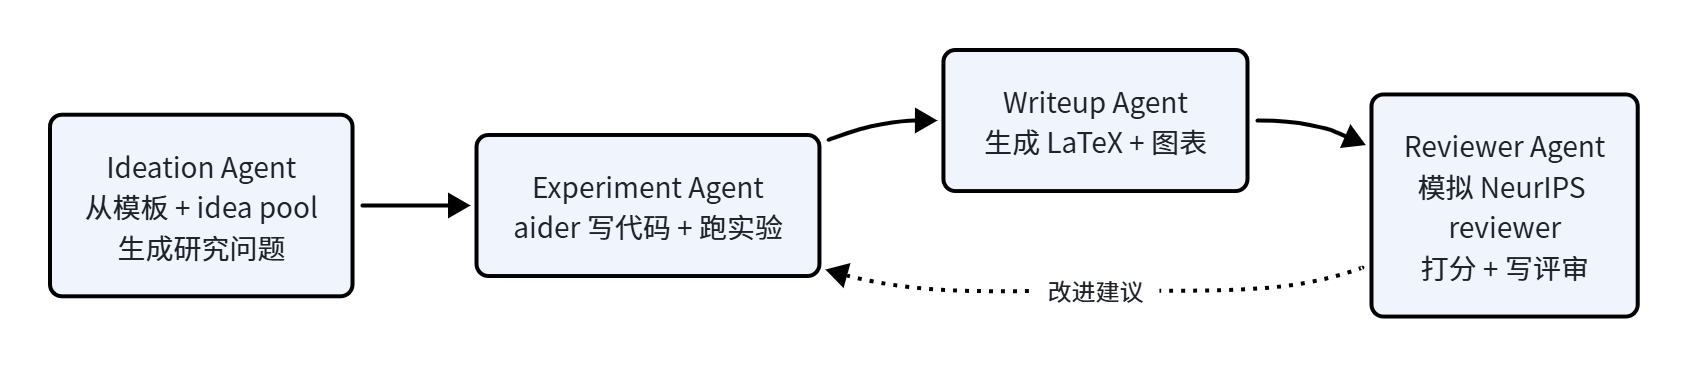
它的优势在于构建多角色科研流水线,覆盖 idea 生成、实验设计、论文撰写全流程,产物(论文 + 代码 + figure)形态完整。但评审机制主观、任务串行效率低,资源利用低于并行 AAR无工业落地适配能力。
上述各方案分别在算法调参、并行优化、论文生成方面各具特色。而小米 AutoResearch 覆盖论文调研→算法设计→实验执行→评测分析→落地交付→知识沉淀六环节的完整工业生产线,打通从学术研究到模型上车、量产落地的全闭环,真正适配人车家全生态复杂工业场景。
05
落地实践成果与价值验证
目前,小米 AutoResearch 已在 热管理、附件能耗预估、EMB 电子机械制动夹紧力估计 等核心场景落地实证,成效显著:
研发效率大幅跃升:面向整车研发中纯数据驱动、数据与机理结合建模、科学发现这三类业务场景,团队构建 AI Native 热管理研发范式,将研发效率提升 15 倍以上(原需 90 人天的工作,现仅需 6 人天即可完成)。
模型性能对标超越:在附件能耗预估、EMB 夹紧力估计项目中,模型精度逼近甚至超越结构化大模型与传统自研算法,实现性能与效率双向突破。
范式通用可快速复用:Orchestrator 调度核心、智能体分工架构通用,切换不同研发场景仅需更新模板与需求配置,智能体无需任何改动,具备极强的生态扩展能力。
_20260914175450A077.png) 系统架构图
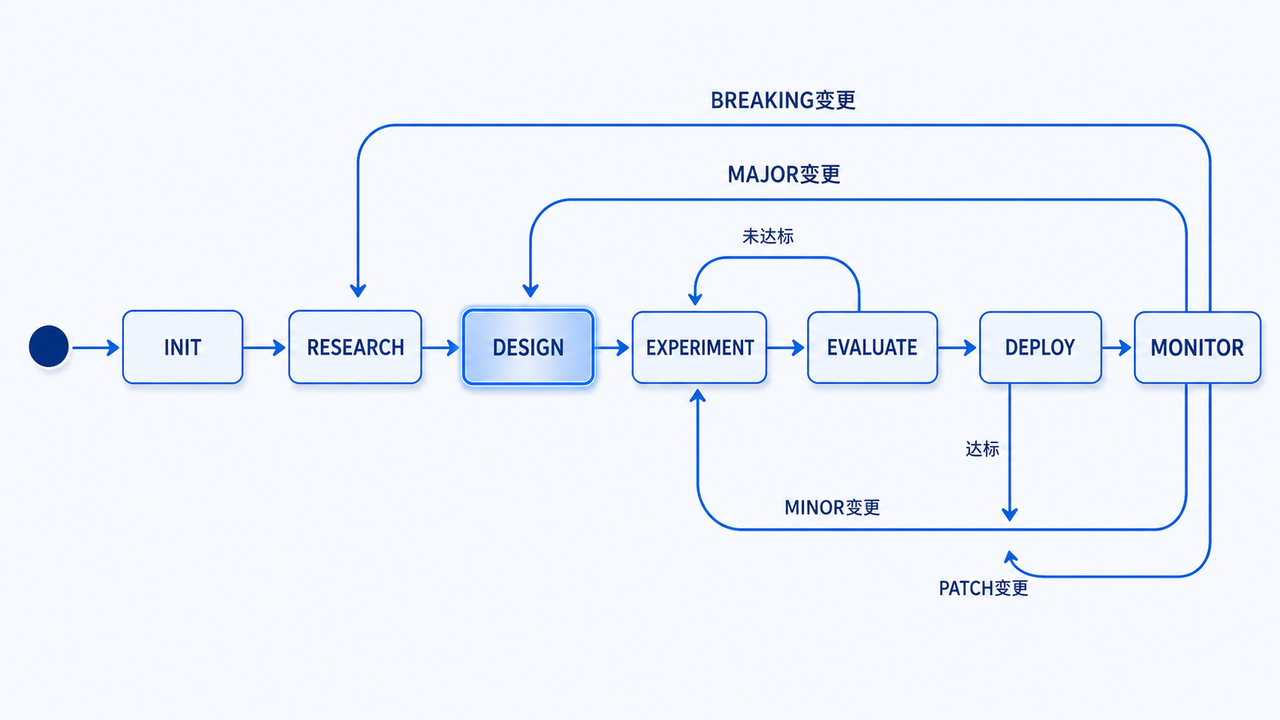 Orchestrator 状态机
小米 AutoResearch AI-Native 研发新范式已实现算法研发 80% 模式化工作自动化,覆盖四大核心 AI 建模场景与人车家关键业务领域。未来,平台将持续拓展全生态研发场景覆盖,深化多智能体协同能力、强化机理融合与数据合成技术,进一步拉大研发效率差距,以 AI 赋能算法研发全流程,持续夯实小米在智能汽车、智能家居、智能终端领域的技术壁垒,为全生态智能化创新注入核心动力。